Guía de resolución — Examen de Sistemas Digitales II, Junio 2025 (19-06-2025)
Guía modelo para preparar la convocatoria de nov-dic 2026. El examen tiene 4 problemas: montacargas ASM + VHDL (3 p), PicoBlaze de 8 puertos de entrada y 4 de salida (2,5 p), mapa de memoria de 1M posiciones con bus de 16 bits (2 p) y CPU von Neumann — microoperaciones + unidad de control (2,5 p).
Importante: el profesor no puntúa ejercicios mal planteados. Escribe siempre el planteamiento (2-3 frases) antes de desarrollar, justifica cada elección y deja verificable el resultado final (tablas, direcciones, código).
Problema 1 — Montacargas entre dos plantas: ASM + VHDL (3 puntos)
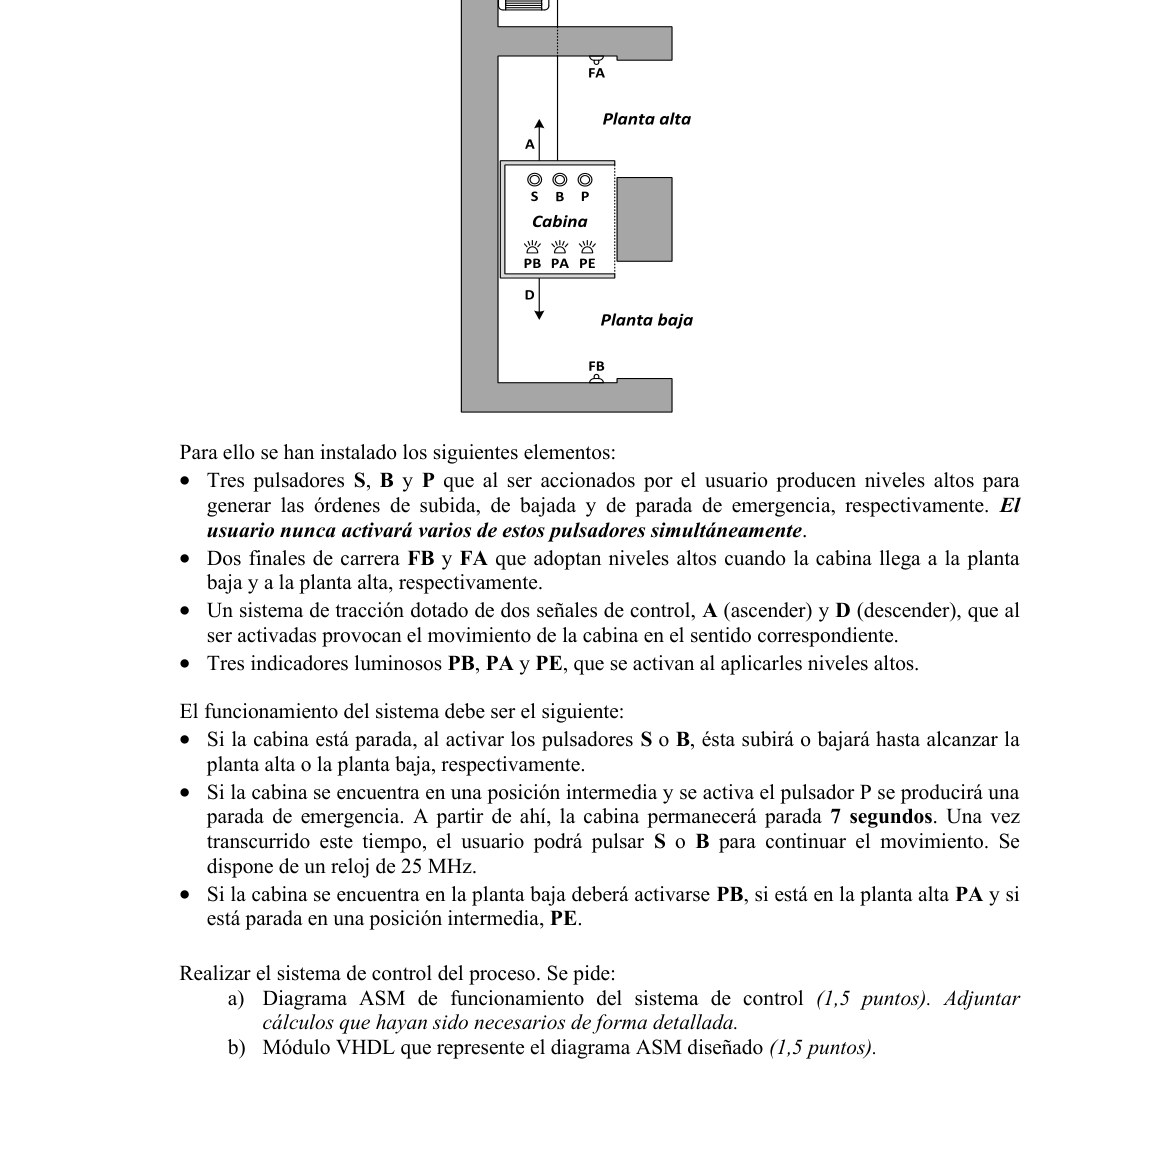
Planteamiento. Es una ASM con la cabina en uno de cuatro "descansos" (planta baja, planta alta, intermedio, congelado 7 s) y dos estados de movimiento (SUBIR, BAJAR). Los finales de carrera FB/FA terminan el movimiento y los pulsadores S/B lo inician; P solo tiene efecto con la cabina en trayectoria o posición intermedia y lleva a un estado PARADA_7S que congela la tracción un tiempo fijo de 7 s generado con un contador de 28 bits sobre el reloj de 25 MHz (como calcula la solución oficial). Los indicadores PB/PA/PE dependen solo del descanso en el que está la máquina (salidas de Moore).
Datos que fija el enunciado y decisiones de diseño. Fija el enunciado: los
elementos y sus niveles —pulsadores S, B, P activos a nivel alto (el usuario
nunca activará varios simultáneamente), finales de carrera FB/FA altos al
llegar a planta baja/alta, señales de tracción A (ascender) y D (descender),
indicadores PB/PA/PE activados con nivel alto—, el comportamiento (parada + S/B →
subir/bajar hasta la planta correspondiente; P solo produce efecto "si la cabina se
encuentra en una posición intermedia" → parada de emergencia y 7 s parado tras
los cuales el usuario vuelve a poder pulsar S o B; reloj de 25 MHz; PB/PA/PE según
la posición) y el baremo: a) diagrama ASM (con cálculos): 1,5 p · b) módulo VHDL:
1,5 p. Decisiones de diseño (no las fija el enunciado): el estado de arranque
RECONOCE, que lee FB/FA para situar la cabina; ignorar P en las plantas (fuera de
una posición intermedia no hay emergencia); el temporizador como contador único
MOD-175.000.000 de 28 bits — es lo que calcula la solución oficial («Necesitamos un
contador de 28 bits», pág. 1); alternativa equivalente: cascada MOD-10⁶ × MOD-175
con CIs estándar; los nombres de los 7 estados; y el reset del VHDL (obligatorio:
se añade a los puertos junto con el reloj, Tema 3 pág. 30).
Cálculo del temporizador de 7 s (imprescindible, va en el apartado a)
Con reloj de 25 MHz:
7 s × 25.000.000 pulsos/s = 175.000.000 pulsos
La cuenta cabe en un solo contador: 2²⁸ = 268.435.456 ≥ 175.000.000 → contador de
28 bits con MAX = 175.000.000, el cálculo que aparece en la solución oficial
(CLK=25 MHz; T=40 ns; x = 7/(40·10⁻⁹) = 175·10⁶; «Necesitamos un contador de 28 bits»).
También es válida (y muy usada con CIs reales) la descomposición en dos etapas:
| Etapa | Módulo | Cuenta con | Resultado | Bits necesarios |
|---|---|---|---|---|
| Pre-escala | MOD-1.000.000 | 25 MHz | 25 Hz (un pulso cada 40 ms) | 20 (2²⁰ = 1.048.576 ≥ 10⁶) |
| Contador de segundos | MOD-175 | 25 Hz | 175 × 40 ms = 7,00 s justos | 8 (2⁸ = 256 ≥ 175) |
Comprobación: 1.000.000 × 175 = 175.000.000 ✔ y 175·10⁶ / 25·10⁶ = 7 s ✔.
El contador solo cuenta mientras la ASM está en PARADA_7S (señal de habilitación
EN_T) y se limpia al entrar. El nivel T (terminal de cuenta, cont ≥ MAX) pasa a 1 tras
175.000.000 pulsos y provoca la salida del estado.
Con contador único de 28 bits el dimensionado es el de la propia solución oficial; la cascada 10⁶ × 175 se cablea con CIs estándar y reparte el conteo en dos chips.
📚 Teoría: Tema 2, pág. 56–58 del PDF «Tema 2 SD-II_20200317.pdf» — contador síncrono con habilitación y borrado; asociación de contadores para lograr mayor módulo (asociación síncrona usando las habilitaciones de cuenta).
a) Diagrama ASM — 7 estados (1,5 p)
Bloques ASM (uno por estado; entre corchetes las salidas activas del estado; "sin transición" = permanecer; T = fin de los 7 s):
| # | Estado (bloque ASM) | Salida | Decisiones → siguiente estado |
|---|---|---|---|
| 1 | RECONOCE (arranque) |
— | FB=1 → PARADA_BAJO; FA=1 → PARADA_ALTO; si no → PARADA_INTERMEDIA |
| 2 | PARADA_BAJO |
PB | S=1 → SUBIR (B y P se ignoran: ya está abajo) |
| 3 | PARADA_ALTO |
PA | B=1 → BAJAR (S y P se ignoran) |
| 4 | PARADA_INTERMEDIA |
PE | S=1 → SUBIR; B=1 → BAJAR |
| 5 | SUBIR |
A | FA=1 → PARADA_ALTO; si no, P=1 → PARADA_7S; si no → SUBIR |
| 6 | BAJAR |
D | FB=1 → PARADA_BAJO; si no, P=1 → PARADA_7S; si no → BAJAR |
| 7 | PARADA_7S |
PE (sin A ni D) | T=0 → quedarse; T=1 → PARADA_INTERMEDIA (S/B ignoradas durante los 7 s) |
Claves del planteamiento (lo que puntúa):
- Los estados de movimiento no deciden a la vez FB y FA: subiendo solo importa FA
(y P con prioridad por debajo), bajando solo FB. Así FB tiene prioridad natural al
llegar a la planta baja aunque P esté pulsada a la vez.
- PARADA_7S dura lo que dure el temporizador: la transición de salida depende del
nivel T (terminal de cuenta del contador, cont ≥ MAX), no de un reloj fijo de la ASM.
- PE cumple el enunciado en los dos casos: parada intermedia tras la emergencia y
arranque con la cabina entre plantas. PB/PA solo en las plantas.
- Los pulsadores S y B se ignoran explícitamente dentro de PARADA_7S (la cabina
"permanecerá parada 7 segundos": el usuario actúa después).
- El enunciado dice que S/B/P nunca se activan a la vez: no hace falta priorizarlas
entre sí, solo frente a los finales de carrera.
Ejemplo de recorrido: planta baja →(S) SUBIR →(P a mitad) PARADA_7S[PE=1, 7 s, S/B ignoradas] →(T) PARADA_INTERMEDIA[PE=1] →(B) BAJAR →(FB) PARADA_BAJO[PB=1].
📚 Teoría: Tema 3, pág. 15–19 del PDF «Tema 3 SD-II_20200413.pdf» — diagramas ASM: cajas de estado y decisión, bloques ASM; un bloque ASM equivale a un estado del diagrama de estados.
b) Módulo VHDL del ASM (1,5 p)
library IEEE;
use IEEE.STD_LOGIC_1164.ALL;
use IEEE.STD_LOGIC_UNSIGNED.ALL;

entity montacargas is
  port ( clk, reset      : in  std_logic;   -- reloj de 25 MHz y reset
         S, B, P, FB, FA : in  std_logic;   -- pulsadores y finales de carrera
         A, D            : out std_logic;   -- traccion: ascender / descender
         PB, PA, PE      : out std_logic ); -- indicadores
end montacargas;

architecture asm of montacargas is
  -- nombres de estado = nombres de los bloques del diagrama ASM
  type mis_estados is (RECONOCE, PARADA_BAJO, PARADA_ALTO, PARADA_INTERMEDIA,
                       SUBIR, BAJAR, PARADA_7S);
  signal estado : mis_estados;
  -- temporizador de 7 s: contador unico de 28 bits (2^28 > 175.000.000)
  constant MAX      : integer := 175000000;  -- 7 s / 40 ns = 175M pulsos
  constant cont_bit : integer := 28;
  signal cont : std_logic_vector(cont_bit-1 downto 0);
begin
  process
    begin
      wait until clk = '1';
      if (reset = '1') then
        estado <= RECONOCE;
        cont <= (others => '0');
        A <= '0'; D <= '0'; PB <= '0'; PA <= '0'; PE <= '0';
      else
        case estado is
          when RECONOCE =>                    -- arranque: situar la cabina
            A <= '0'; D <= '0'; PB <= '0'; PA <= '0'; PE <= '0';
            cont <= (others => '0');
            if (FB = '1') then        estado <= PARADA_BAJO;
            elsif (FA = '1') then     estado <= PARADA_ALTO;
            else                      estado <= PARADA_INTERMEDIA;
            end if;
          when PARADA_BAJO =>
            PB <= '1'; A <= '0'; D <= '0'; PA <= '0'; PE <= '0';
            if (S = '1') then estado <= SUBIR; end if;
          when PARADA_ALTO =>
            PA <= '1'; A <= '0'; D <= '0'; PB <= '0'; PE <= '0';
            if (B = '1') then estado <= BAJAR; end if;
          when PARADA_INTERMEDIA =>
            PE <= '1'; A <= '0'; D <= '0'; PB <= '0'; PA <= '0';
            if (S = '1') then     estado <= SUBIR;
            elsif (B = '1') then  estado <= BAJAR;
            end if;
          when SUBIR =>
            A <= '1'; D <= '0'; PA <= '0'; PB <= '0'; PE <= '0';
            cont <= (others => '0');          -- el contador llega a 0 al entrar en PARADA_7S
            if (FA = '1') then    estado <= PARADA_ALTO;
            elsif (P = '1') then  estado <= PARADA_7S;
            end if;
          when BAJAR =>
            D <= '1'; A <= '0'; PA <= '0'; PB <= '0'; PE <= '0';
            cont <= (others => '0');
            if (FB = '1') then    estado <= PARADA_BAJO;
            elsif (P = '1') then  estado <= PARADA_7S;
            end if;
          when PARADA_7S =>
            PE <= '1'; A <= '0'; D <= '0'; PB <= '0'; PA <= '0';
            if (cont + 1 >= MAX) then         -- la decision del ASM se toma tras la suma:
              estado <= PARADA_INTERMEDIA;    -- 175.000.000 ciclos justos = 7,000 s
              cont <= (others => '0');
            else
              cont <= cont + 1;
            end if;
          when others =>
            estado <= RECONOCE;
            cont <= (others => '0');
            A <= '0'; D <= '0'; PB <= '0'; PA <= '0'; PE <= '0';
        end case;
      end if;
  end process;
end asm;
Notas para el examen: UN SOLO proceso (Tema 3, pág. 30–32: el ASM se traduce
estado a estado, con reloj y reset añadidos a los puertos de la tarjeta identificativa).
El reset es obligatorio y deja la máquina en el bloque inicial del ASM (igual que
la caja CONT=0; A=0,D=0; PA,PB,PE=0 de la solución oficial). Cada rama when escribe
TODAS las salidas: dentro de un proceso las salidas se conservan entre flancos (memoria
implícita, Tema 2 pág. 15), así que una rama que no escriba una salida la deja encendida.
El contador se limpia en todas las ramas salvo PARADA_7S (llega a 0 al entrar; un contador
que nunca se limpia es el fallo clásico). En el examen se escribe la constante real
175000000; para simular se reduce MAX (o se parametriza con GENERIC(max, cont_bit)
como el antirrebote_par de Tema 3, pág. 33–34).
📚 Teoría: Tema 3, pág. 23–24 del PDF «Tema 3 SD-II_20200413.pdf» — diagrama ASM y módulo VHDL equivalente. 📚 Teoría: Tema 3, pág. 30–32 del PDF «Tema 3 SD-II_20200413.pdf» — traducción de ASM a VHDL: descripción de comportamiento estado a estado, sin estructura de componentes. 📚 Teoría: Tema 3, pág. 33–34 del PDF «Tema 3 SD-II_20200413.pdf» — simulación en VHDL usando parametrización: la cuenta máxima del contador se reduce para poder simular.
Errores típicos — P1
- No escribir el cálculo de los 175.000.000 pulsos y su descomposición: es parte del punto del apartado a ("adjuntar cálculos de forma detallada").
- Temporizador corriendo siempre (no habilitado solo en PARADA_7S) o sin limpiarlo al salir: la segunda emergencia sería inmediata.
- Aceptar S/B durante los 7 s: el enunciado dice que el usuario pulsa "una vez transcurrido este tiempo" → en PARADA_7S no se miran S ni B.
- Olvidar PE en la parada intermedia (o poner PE solo durante los 7 s): PE indica "parada en posición intermedia", también tras acabar la cuenta.
- Proceso combinacional sin valores por defecto (latches) o
caseincompleto. - Estados llamados E0, E1…: deben coincidir con los bloques del ASM.
- En SUBIR decidir FB=0 → seguir: FB no para la subida (la cabina sale de la planta baja con FB=1); la parada es solo por FA.
- P con prioridad sobre FA/FB: al llegar a una planta manda el final de carrera aunque P esté pulsada a la vez (los estados de movimiento deciden primero FB/FA).
Esquema-resumen de la metodología
- Separar lo que fija el enunciado de las decisiones de diseño — fija: niveles activos de S/B/P y de los finales FB/FA, tracciones A/D, indicadores PB/PA/PE, el comportamiento de paradas y emergencia (P solo con la cabina en posición intermedia, 7 s), el reloj de 25 MHz y el baremo (ASM con cálculos 1,5 p + VHDL 1,5 p); se decide: el estado de arranque
RECONOCE, ignorar P en las plantas, el temporizador como contador único MOD-175.000.000 de 28 bits (el de la solución oficial; alternativa: cascada MOD-10⁶ × MOD-175), los nombres de los 7 estados y elresetdel VHDL (obligatorio junto al reloj). - Calcular el temporizador de 7 s antes de dibujar y escribir los cálculos en el apartado a — 7 s × 25 MHz = 175.000.000 pulsos → contador de 28 bits con MAX = 175.000.000 (2²⁸ = 268.435.456 ≥ 175·10⁶), el cálculo literal de la solución oficial; alternativa válida: pre-escala MOD-1.000.000 (20 bits, da 25 Hz) en cascada con MOD-175 (8 bits), 175 × 40 ms = 7,00 s justos.
- Habilitar y limpiar el contador solo en PARADA_7S — cuenta únicamente mientras la ASM está en ese estado (habilitación EN_T) y se limpia al salir, para que la segunda emergencia no sea inmediata; el terminal T pasa a 1 tras 175.000.000 pulsos y provoca la salida del estado.
- Tabular la ASM con un bloque por estado y nombres propios —
RECONOCE(arranque: lee FB/FA para situar la cabina),PARADA_BAJO[PB],PARADA_ALTO[PA],PARADA_INTERMEDIA[PE],SUBIR[A],BAJAR[D],PARADA_7S[PE sin A ni D]; las salidas dependen solo del descanso o movimiento (Moore). - Acotar las decisiones de los estados de movimiento — subiendo solo decide FA (y después P), bajando solo FB: al llegar a una planta manda el final de carrera aunque P esté pulsada a la vez; el enunciado dice que S/B/P nunca se activan a la vez, así que no hace falta priorizarlas entre sí.
- Cumplir los 7 s como plazo duro — dentro de PARADA_7S se ignoran explícitamente S y B (el usuario pulsa «una vez transcurrido este tiempo») y la transición de salida cuelga del nivel T, no de un reloj fijo de la ASM.
- Recorrer un ejemplo sobre el diagrama — planta baja →(S) SUBIR →(P a mitad) PARADA_7S[PE=1, 7 s, S/B ignoradas] →(T) PARADA_INTERMEDIA[PE=1] →(B) BAJAR →(FB) PARADA_BAJO[PB=1]: se comprueban los descansos y que PE cubre parada intermedia y emergencia.
- Traducir a VHDL 1:1 con la ASM —
type mis_estadoscon los mismos nombres que los bloques del diagrama; un solo proceso conwait until clk='1'(oclk='1' and clk'event),resetsíncrono que dejaestado,conty salidas como la caja inicial del ASM,case estado iscon las salidas de cada estado escritas dentro de la rama (todas, para que ninguna quede enganchada por la memoria implícita) ywhen others; el contadorcontes unstd_logic_vector(cont_bit-1 downto 0)que solo suma enPARADA_7S. - Hacer la cuenta simulable — en el examen se escribe la constante real
175000000; para simular se reduceMAXa unas pocas unidades (o se parametriza conGENERIC(max, cont_bit)como elantirrebote_parde Tema 3, pág. 33–34).
Idea transversal: el temporizador de un estado cronometrado es un contador externo habilitado solo mientras la ASM permanece en PARADA_7S y borrado al salir — la salida del estado cuelga del nivel terminal T, no de un número fijo de relojes; PB/PA/PE son salidas puras de Moore del estado, y ASM y VHDL son el mismo diseño dicho dos veces, con los mismos nombres estado a estado.
Problema 2 — PicoBlaze: 8 puertos de entrada, 4 de salida (2,5 puntos)
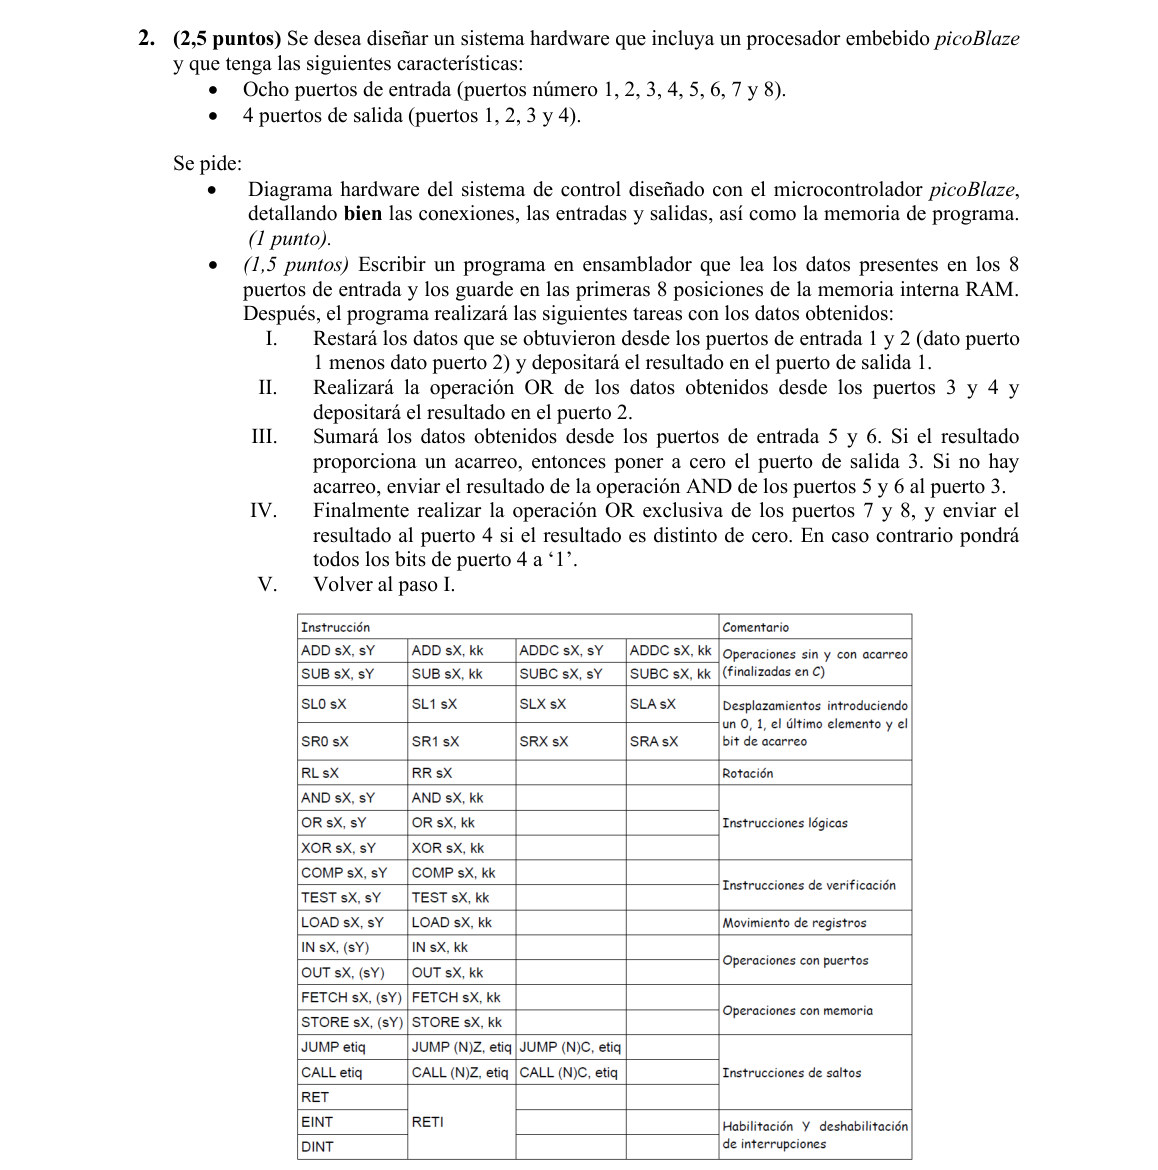
Planteamiento. El PicoBlaze (núcleo KCPSM6 embebido en FPGA, 16 registros s0–sF,
RAM scratchpad interna y bus E/S de 256 puertos identificados por port_id) lee los 8
puertos de entrada (ids 01H–08H), copia sus valores a las 8 primeras posiciones de la
RAM interna con STORE y los conserva en registros (s1–s8) para las cuatro tareas
combinacionales, que se re-ejecutan en bucle infinito. La ROM de programa es externa
al núcleo (1024×18) y debe aparecer en el diagrama. No hay interrupciones.
Datos que fija el enunciado y decisiones de diseño. Fija el enunciado: ocho
puertos de entrada (puertos número 1, 2, … 8) y cuatro de salida (puertos 1, 2,
3 y 4), las lecturas y tareas I…V en orden (P1−P2→salida 1; OR de 3 y 4→salida 2;
suma 5+6: con acarreo → salida 3 a cero, sin acarreo → AND de 5 y 6 a salida 3; XOR
de 7 y 8: no nulo → salida 4, nulo → todos los bits de salida 4 a 1; volver al paso
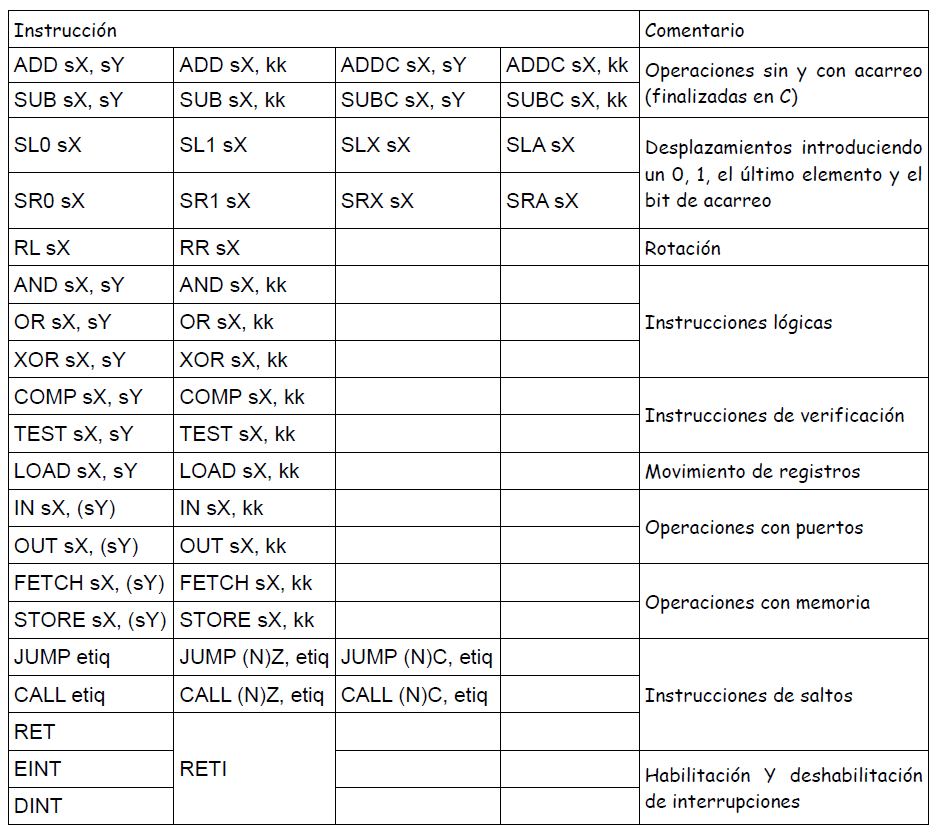
I), y la tabla ISA impresa en el propio examen junto al enunciado, que es la
referencia obligatoria de los mnemónicos: puertos solo como IN sX,kk / IN sX,(sY)
y OUT sX,kk / OUT sX,(sY) (la tabla no imprime INPUT/OUTPUT), ADD y
ADDC —e SUB y SUBC— como instrucciones distintas, COMP/TEST, LOAD,
AND/OR/XOR, FETCH/STORE, desplazamientos y rotaciones, saltos JUMP etiq /
JUMP (N)Z, etiq / JUMP (N)C, etiq, CALL/RET/RETI y EINT/DINT. Baremo:
diagrama hardware 1 p · programa ensamblador comentado 1,5 p. Decisiones de
diseño (no las fija el enunciado): interpretar los números de puerto como
identificadores port_id H"01"–H"08" (entradas) y H"01"–H"04" (salidas); sin
interrupciones (interrupt_port sin usar: el enunciado no las menciona, aunque la
tabla las incluya); ROM de programa externa 1024×18 y RAM scratchpad interna
64×8, con las 8 primeras posiciones 00H–07H (tamaños de clase, no impresos); y la
convención de flags, que la tabla no detalla y hay que declarar: ADD/ADDC
dejan en C el acarreo de la suma y SUB/SUBC/COMP dejan C=1 si no hay
préstamo; ADD/SUB no leen la C de entrada (para eso existen ADDC/SUBC);
las instrucciones lógicas (AND/OR/XOR) actualizan Z y dejan C=0.
a) Diagrama hardware (1 p) — descripción detallada
- Bloque KCPSM6 con sus puertos:
clk,reset,input_port(7:0),output_port(7:0),port_id(7:0),read_strobe,output_port_strobe(7:0)(en KCPSM3 se llamawrite_strobe), y las líneas de la ROM:program_port_addr(9:0)yprogram_port_instruction(17:0).interrupt_portsin usar. - Memoria de programa: ROM externa 1024×18 (block RAM de la FPGA): direcciones 000H–3FFH con instrucciones de 18 bits. Dibujarla SIEMPRE pegada al núcleo.
- Ocho puertos de entrada IN1–IN8 (8 bits cada uno) a un multiplexor de entrada.
Un decodificador de
port_id(comparadores H'01'–H'08') activa la rama del multiplexor seleccionada cuandoread_strobepulsa (instante de unIN). - Cuatro puertos de salida OUT1–OUT4: registros/latches de salida cargados desde
output_port(7:0)cuandooutput_port_strobe[n]está activo y el comparador deport_idda H'0n' (n = 1..4). - RAM interna scratchpad (64×8, dentro del módulo): el
STOREescribe; aquí se usan las posiciones 00H–07H. Su puerto de lectura puede quedar disponible para otros circuitos (o usarseFETCHen KCPSM6).
Figura: diagrama hardware del PicoBlaze (KCPSM6) con ROM externa pegada, los 8 puertos de entrada hacia el MUX pilotado por port_id/read_strobe, y 4 latches hacia OUT1–OUT4 pilotados por comparador + output_port_strobe (apartado a).
📚 Teoría: Tema 4, pág. 11–12 del PDF «Tema 4 SD-II_20220512.pdf» — PicoBlaze: núcleo firmcore de 8 bits embebido en FPGA; características y diagrama de bloques (16 registros, ALU con flags CARRY/ZERO, scratchpad de 64 bytes, 256 puertos de E/S). 📚 Teoría: Tema 4, pág. 31–34 del PDF «Tema 4 SD-II_20220512.pdf» — puertos de E/S: PORT_ID, READ_STROBE/OUT_PORT, conexión de múltiples entradas al bus IN_PORT y de salidas a la lógica de la FPGA. 📚 Teoría: Tema 4, pág. 45 del PDF «Tema 4 SD-II_20220512.pdf» — configuración estándar de almacenamiento del programa: módulo KCPSM6 más bloque RAM 1K×18 externo con WE fijo a nivel bajo para formar la ROM.
b) Programa ensamblador comentado (1,5 p)
El programa se ciñe a la tabla ISA impresa en el examen (los únicos mnemónicos
válidos aquí son IN, OUT, LOAD, STORE, ADD, SUB, AND, OR, XOR,
COMP, JUMP…) y a la convención de flags declarada en el recuadro anterior. Las
tareas III y IV cubren las dos ramas de cada decisión (con/sin acarreo, resultado
nulo/no nulo), como muestran los vectores de prueba del final del apartado.
;=====================================================================
; PicoBlaze KCPSM6 - Examen Junio 2025, problema 2
; 8 puertos de entrada (puertos numero 1..8 -> port_id H"01"..H"08")
; 4 puertos de salida (puertos 1..4 -> port_id H"01"..H"04")
; Mnemonicos: SOLO los de la tabla ISA impresa en el examen (IN/OUT
; con kk; ADD y ADDC instrucciones distintas; saltos JUMP etiq y
; JUMP (N)Z,etiq / JUMP (N)C,etiq)
; s1..s8 = datos de los puertos 1..8 (SE CONSERVAN todo el bucle)
; s9 = registro de trabajo (copia)
; Convencion de flags (la tabla no la fija; se declara en el examen):
;   ADD deja en C el acarreo de la suma; SUB/COMP dejan C=1 si NO hay
;   prestamo; ADD/SUB no leen la C de entrada (para eso estan
;   ADDC/SUBC); las logicas (AND/OR/XOR) actualizan Z y dejan C=0.
;=====================================================================
PE1     EQU H"01"         ; puerto de entrada 1 ... PE8 EQU H"08"
PE2     EQU H"02"
PE3     EQU H"03"
PE4     EQU H"04"
PE5     EQU H"05"
PE6     EQU H"06"
PE7     EQU H"07"
PE8     EQU H"08"
PS1     EQU H"01"         ; puerto de salida 1 ... PS4 EQU H"04"
PS2     EQU H"02"
PS3     EQU H"03"
PS4     EQU H"04"

        ORG H"000"
;---- lectura de los 8 puertos y guardado en las 8 primeras
;---- posiciones de la RAM scratchpad (00H..07H)
LECTURA:
        IN s1, PE1        ; leo puerto de entrada 1 (IN sX,kk de la tabla)
        IN s2, PE2        ; ...
        IN s3, PE3
        IN s4, PE4
        IN s5, PE5
        IN s6, PE6
        IN s7, PE7
        IN s8, PE8
        STORE s1, H"00"   ; posicion 00H de la RAM <- dato puerto 1
        STORE s2, H"01"   ; posicion 01H <- dato puerto 2
        STORE s3, H"02"
        STORE s4, H"03"
        STORE s5, H"04"
        STORE s6, H"05"
        STORE s7, H"06"
        STORE s8, H"07"
;---- TAREA I: P1 - P2 -> salida 1
TAREA_1:
        LOAD s9, s1      ; copia de trabajo: NO toco s1 (se reutiliza)
        SUB s9, s2       ; s9 = P1 - P2 exacto (SUB sin acarreo: no lee la C)
        OUT s9, PS1      ; resultado al puerto de salida 1 (OUT sX,kk)
;---- TAREA II: P3 OR P4 -> salida 2
TAREA_2:
        LOAD s9, s3      ; copia de trabajo de P3
        OR s9, s4        ; s9 = P3 OR P4
        OUT s9, PS2
;---- TAREA III: P5+P6; si acarreo -> salida 3 = 0; si no -> P5 AND P6
TAREA_3:
        LOAD s9, s5      ; copia de trabajo de P5
        ADD s9, s6       ; s9 = P5+P6; C = acarreo REAL de esta suma
        JUMP C, C3_CERO   ; C=1 -> hubo acarreo (JUMP C,etiq de la tabla)
        LOAD s9, s5      ; sin acarreo: recompongo P5 en la copia
        AND s9, s6       ; s9 = P5 AND P6 (s5 y s6 siguen intactas)
        OUT s9, PS3
        JUMP TAREA_4
C3_CERO:
        LOAD s9, H"00"   ; con acarreo: puerto de salida 3 a cero
        OUT s9, PS3
;---- TAREA IV: P7 XOR P8; si != 0 -> salida 4; si = 0 -> todos los bits a 1
TAREA_4:
        LOAD s9, s7      ; copia de trabajo de P7
        XOR s9, s8       ; s9 = P7 XOR P8; las logicas dejan Z=1 si el resultado es 0
        JUMP Z, C4_TODO1  ; Z=1 -> resultado cero (JUMP Z,etiq de la tabla)
        OUT s9, PS4      ; resultado distinto de cero -> al puerto 4
        JUMP TAREA_5
C4_TODO1:
        LOAD s9, H"FF"   ; resultado cero: todos los bits a 1
        OUT s9, PS4
;---- TAREA V: bucle infinito: volver al paso I
TAREA_5:
        JUMP TAREA_1
Justificaciones que conviene escribir en el examen:
- La tabla del examen separa las variantes sin/con acarreo: ADD/SUB no
leen la C de entrada (solo la producen: desbordamiento en ADD; y en SUB/COMP
C=1 si no hay préstamo, según la convención declarada). Por eso la resta de la
tarea I y la suma de la III son exactas sin ningún truco previo, y el JUMP C,
situado justo detrás del ADD lee el acarreo real de P5+P6. Si algún día
quisieras sumar tomando el acarreo anterior, existiría ADDC — que aquí NO toca.
- El resultado del ADD está en s9; para el AND hacen falta los originales P5 y
P6: se conservan en s5/s6 (por eso se trabaja con la copia s9). Alternativa
igualmente válida: FETCH s9,H"04" para releer la scratchpad.
- Las instrucciones lógicas actualizan Z (convención declarada): el XOR de la
tarea IV deja Z=1 si el resultado es 0 y el JUMP Z, decide sin usar COMP.
Alternativa explícita si prefieres no fiarte: COMP s9,H"00" justo tras el XOR
(COMP calcula s9−0 y deja esa Z).
- La tarea V dice "volver al paso I" → JUMP TAREA_1 literal (los datos de los puertos
se reutilizan del paso anterior). Si prefirieras releer los puertos en cada ciclo,
se cambia a JUMP LECTURA — dilo en una línea y queda cubierto.
- Direcciones del STORE: el enunciado pide las 8 primeras posiciones; se usa
direccionamiento directo H"00"..H"07". Válido también indirecto STORE sX,(sY)
con un puntero.
📚 Teoría: Tema 4, pág. 23 del PDF «Tema 4 SD-II_20220512.pdf» — instrucciones lógicas (AND/OR/XOR): el flag ZERO se pone a 1 si el resultado es cero y el flag CARRY siempre queda a 0 tras una operación lógica. 📚 Teoría: Tema 4, pág. 30 del PDF «Tema 4 SD-II_20220512.pdf» — control del flujo: JUMP/CALL/RETURN condicionados a los flags ZERO y CARRY. 📚 Teoría: Tema 4, pág. 40 del PDF «Tema 4 SD-II_20220512.pdf» — scratchpad RAM interna de 64 bytes: escritura y lectura con STORE y FETCH, direccionamiento indirecto vía registro, y su contenido no se ve afectado por RESET.
Vectores de prueba (salidas 1..4 tras una vuelta del bucle; resultados calculados a mano aplicando la convención de flags declarada):
| P1..P8 | salida 1 | salida 2 | salida 3 | salida 4 |
|---|---|---|---|---|
| 50,20,0F,F0,80,7F,55,55 | 30 | FF | 00 (80+7F=FF sin acarreo → 80 AND 7F) | FF (55⊕55=0) |
| 90,80,12,34,90,80,12,34 | 10 | 36 | 00 (90+80=110H con acarreo) | 26 |
| 10,30,00,00,01,02,AA,55 | E0 (P1<P2, complemento) | 00 | 00 (1+2=3 sin acarreo → AND=0) | FF |
| 80,01,AA,55,80,81,00,00 | 7F | FF | 00 (80+81=101H con acarreo) | FF (0⊕0=0) |
| 7F,01,01,02,80,7F,01,02 | 7E | 03 | 00 (80+7F=FF sin acarreo → AND) | 03 |
Errores típicos — P2
- Usar
INPUT/OUTPUT(alias de ensambladores comerciales): la tabla ISA impresa en el examen solo contieneIN sX,kk/IN sX,(sY)yOUT sX,kk/OUT sX,(sY). Escribe la tabla tal cual, aunque tu ensamblador del PC admita otros alias. - Usar
ADDC/SUBCdonde tocaADD/SUB(o al revés): la tabla las imprime como instrucciones distintas; las variantes "con acarreo" sumarían o restarían además una C que no viene al caso y desajustan las tareas I y III. - No dibujar la ROM externa 1024×18 junto al núcleo, ni los comparadores de
port_id/strobede los puertos. - Usar los registros s1..s8 directamente en las operaciones y destruirlos: después hacen falta para el AND (tarea III) y el XOR (tarea IV). Trabaja siempre con s9.
- Separar el
JUMP C,delADDque produce el acarreo de la tarea III: si en medio hay cualquier instrucción que altere C, la decisión deja de ser "P5+6 desborda". - Creer que
JUMP Z,tras elXORexige unCOMPprevio: la Z la pone la propia instrucción lógica (convenio declarado y comentado en el programa). - No escribir la tarea V (bucle): lo literal del enunciado es volver al paso I,
JUMP TAREA_1; si optas por releer puertos cada ciclo (JUMP LECTURA), dilo. - Programa sin comentar línea a línea: ahí están los 1,5 puntos.
Esquema-resumen de la metodología
- Interpretar los números de puerto como
port_idy declarar antes las convenciones — entradas H"01"..H"08" y salidas H"01"..H"04" conEQUen el encabezado; sin interrupciones (interrupt_portsin usar); ROM de programa externa 1024×18 y RAM scratchpad interna 64×8 (tamaños de clase) usando las posiciones 00H..07H; declarar la convención de flags que la tabla no detalla:ADD/ADDCdejan en C el acarreo,SUB/SUBC/COMPdejan C=1 si NO hay préstamo,ADD/SUBno leen la C de entrada y las lógicas (AND/OR/XOR) actualizan Z y dejan C=0. - Dibujar el hardware con la ROM de programa fuera del núcleo — bloque KCPSM6 con
clk,reset,input_port(7:0),output_port(7:0),port_id(7:0),read_strobe,output_port_strobe(7:0)y las líneas de la ROMprogram_port_addr(9:0)/program_port_instruction(17:0); ROM externa 1024×18 (000H–3FFH, instrucciones de 18 bits) dibujada SIEMPRE pegada al núcleo. - Conectar las 8 entradas vía mux y las 4 salidas vía latches — IN1–IN8 a un multiplexor cuya rama selecciona el decodificador de
port_id(comparadores H'01'–H'08') en el instante deread_strobe;output_port(7:0)a latches habilitados por el comparador deport_id(H'0n', n=1..4) ANDoutput_port_strobe[n]. - Estructurar el programa como lectura + tareas I…V + bucle — en
LECTURA:, ochoIN sX,PEXy ochoSTORE sX,H"0n"a las 8 primeras posiciones de la scratchpad; después TAREA_1 (P1−P2→salida 1), TAREA_2 (P3 OR P4→salida 2), TAREA_3 (P5+P6 según acarreo→salida 3), TAREA_4 (P7⊕P8→salida 4) con suOUT, y TAREA_5 como bucle. - Usar
IN/OUTen la forma kk de la tabla ISA impresa — la tabla del examen no imprimeINPUT/OUTPUT: escribe los mnemónicos tal cual, aunque tu ensamblador admita otros alias;STOREcon direccionamiento directo H"00"..H"07" (también vale indirecto(sY)con puntero). - Trabajar siempre sobre la copia s9 y conservar s1–s8 intactas todo el bucle — la
SUBde la tarea I y laADDde la III se hacen en s9; los originales P5/P6 (y P7/P8) siguen haciendo falta para elANDy elXORposteriores (alternativa válida:FETCHpara releer la scratchpad). - Usar las instrucciones exactas de la tabla y pegar el salto condicional al flag —
ADD/SUBsin acarreo dan operaciones exactas (ADDC/SUBCexisten para el caso contrario y aquí NO toca);JUMP C,situado justo detrás delADDlee el acarreo real de P5+P6; elXORpone Z él solo, así queJUMP Z,decide sinCOMP(alternativa explícita:COMP s9,H"00"detrás). - Cubrir las dos ramas de cada decisión y cerrar el bucle literal — con acarreo → salida 3 a cero (C3_CERO), sin acarreo → P5 AND P6; resultado nulo → todos los bits de salida 4 a 1 (C4_TODO1 con H"FF"), no nulo → el resultado; TAREA_5 es
JUMP TAREA_1(lo literal del enunciado es volver al paso I; si se prefiriera releer puertos cada ciclo,JUMP LECTURAy decirlo en una línea). - Verificar con vectores de prueba calculados a mano y comentar línea a línea — cinco juegos de P1..P8 que cubren acarreo (90+80=110H → salida 3 a 0), sin acarreo con AND, resta P1<P2 (complemento), XOR nulo (55⊕55=0 → FF) y XOR no nulo; los comentarios con la convención de flags declarada son ahí donde están los 1,5 puntos.
Idea transversal: la tabla ISA impresa en el examen es la única referencia de mnemónicos (IN/OUT en forma kk, ADD≠ADDC, saltos sobre Z/C) y todo lo que la tabla no fija (convención de flags, port_id, direcciones de la scratchpad) se declara expresamente en el programa; los datos se conservan en s1–s8 y todas las operaciones se hacen sobre la copia de trabajo s9, y el programa es literalmente la secuencia del enunciado: leer, guardar, tareas I…IV y bucle.
Problema 3 — Mapa de memoria: 1M posiciones × 16 bits (2 puntos)
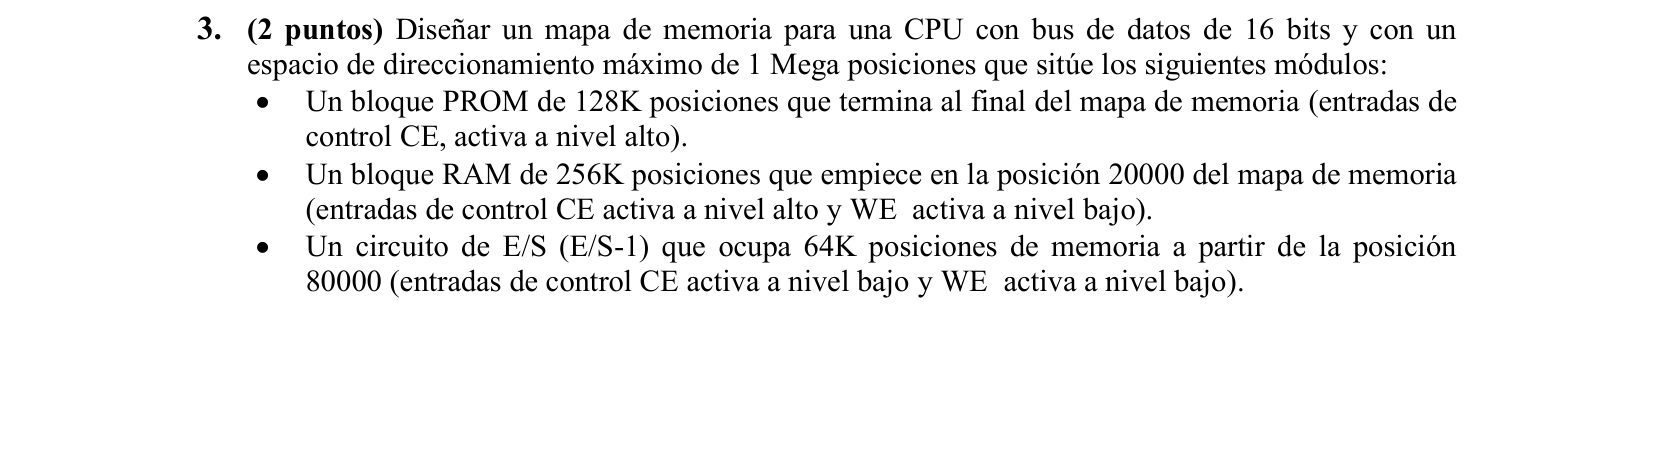
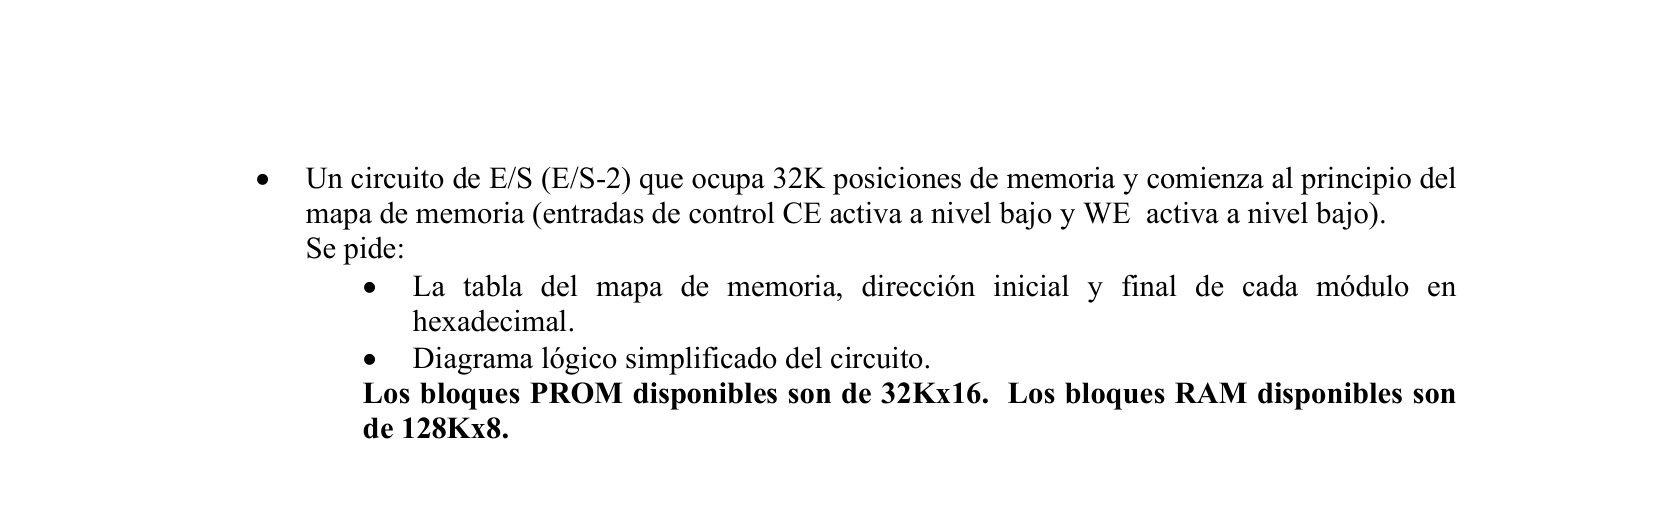
Planteamiento. El espacio de 1 Mega de posiciones de 16 bits exige 2²⁰ = 20 líneas de dirección A19…A0 (mapa 00000H–FFFFFH, direcciones hex de 5 dígitos). Se colocan E/S-2 (32K) al principio, RAM (256K) en 20000H, E/S-1 (64K) en 80000H y la PROM (128K) anclada al final: eso deja tres huecos. Con los CI disponibles (PROM 32K×16 y RAM 128K×8) hay expansión de palabras y de bits y una decodificación con 5 líneas altas A19–A15 respetando la polaridad CE/WE de cada bloque.
Datos que fija el enunciado y decisiones de diseño. Fija el enunciado: bus de datos de 16 bits, espacio de direccionamiento máximo de 1 Mega posiciones (cada posición tiene 16 bits), la PROM de 128K posiciones que termina al final del mapa (CE activa a nivel ALTO), la RAM de 256K posiciones que empieza en la posición 20000 (CE ALTO, WE BAJO), E/S-1 de 64K posiciones a partir de 80000 (CE BAJO, WE BAJO) y E/S-2 de 32K posiciones al principio del mapa (CE BAJO, WE BAJO); los CI disponibles (PROM 32K×16 y RAM 128K×8) y lo pedido: tabla del mapa con dirección inicial y final de cada módulo en hexadecimal y diagrama lógico simplificado. 20000 y 80000 van sin sufijo H en el enunciado: son hexadecimal por contexto (se piden las direcciones "en hexadecimal"). Baremo: el examen fija 2 puntos para todo el ejercicio y no desglosa — reparto habitual: tabla del mapa 1 p · diagrama lógico 1 p. Los tres huecos del mapa no están impresos: se deducen de la colocación pedida. Decisión de diseño: el módulo VHDL de decodificación no se pide este año (se añade como bonus porque en años cercanos sí).
Datos de partida y comprobación de cabida
- 1M posiciones = 2²⁰ = 1.00000H → mapa 00000H–FFFFFH; el bus de datos de 16 bits no reduce el espacio (¡trampa: no usar 16 líneas!).
- Tamaños: 128K = 20000H; 256K = 40000H; 64K = 10000H; 32K = 8000H.
- Suma usada: 128K+256K+64K+32K = 480K ≤ 1024K ✔ cabe.
- Coherencia de las direcciones del enunciado: 20000H y 80000H están dentro de 00000H–FFFFFH ✔.
a) Tabla del mapa de memoria (1 p)
Colocación pedida — al sumar, los módulos (480K) más los huecos (544K) dan exacto 1M, sin solapes y con los tres huecos libres; compruébalo antes de pasar al diagrama:
| Módulo | Tamaño | Inicial | Final | CE | WE | Líneas internas |
|---|---|---|---|---|---|---|
| E/S-2 | 32K | 00000H | 07FFFH | BAJO | BAJO | A14–A0 |
| Hueco | 96K | 08000H | 1FFFFH | — | — | — |
| RAM-A (128K) | 128K | 20000H | 3FFFFH | ALTO | BAJO | A16–A0 |
| RAM-B (128K) | 128K | 40000H | 5FFFFH | ALTO | BAJO | A16–A0 |
| Hueco | 128K | 60000H | 7FFFFH | — | — | — |
| E/S-1 | 64K | 80000H | 8FFFFH | BAJO | BAJO | A15–A0 |
| Hueco | 320K | 90000H | DFFFFH | — | — | — |
| PROM-3 | 32K | E0000H | E7FFFH | ALTO | — | A14–A0 |
| PROM-2 | 32K | E8000H | EFFFFH | ALTO | — | A14–A0 |
| PROM-1 | 32K | F0000H | F7FFFH | ALTO | — | A14–A0 |
| PROM-0 | 32K | F8000H | FFFFFH | ALTO | — | A14–A0 |
Cálculo de la PROM: termina en FFFFFH → empieza en 100000H − 20000H = E0000H. Suma total: 480K usados + 96K + 128K + 320K = 544K libres = 1024K = 1M ✔.
Nº de CI por bloque (expansión de palabras × bits):
| Bloque | CI disponible | Palabras | Bits | Nº CI |
|---|---|---|---|---|
| PROM 128K×16 | PROM 32K×16 | 128K/32K = 4 | 16/16 = 1 | 4 en cascada |
| RAM 256K×16 | RAM 128K×8 | 256K/128K = 2 | 16/8 = 2 | 4 (2 grupos de 2 en paralelo) |
| E/S-1, E/S-2 | módulos hechos | — | — | 1 + 1 |
Trampa de alineación: una RAM de 256K exigiría empezar en un múltiplo de 40000H, y 20000H no lo es (20000H mod 40000H = 20000H). Por eso no existe un único CS de 256K: la selección se hace por dos sectores de 128K (RAM-A 20000H–3FFFFH y RAM-B 40000H–5FFFFH). Escríbelo: demuestra que entiendes la alineación. La PROM en cambio sí cae exacta en un sector de 128K (E0000H–FFFFFH, A19A18A17=111).
📚 Teoría: Tema 5, pág. 32–33 del PDF «Tema 5 SD-II_20230215.pdf» — mapa de memoria: direcciones de m bits según las líneas del bus de direcciones y capacidad direccionable; ejemplo de diseño de mapa con RAM al principio y ROM anclada al final (CE activa ALTA, WE activa BAJA).
b) Decodificación y diagrama lógico simplificado (1 p)
El bloque más pequeño mide 32K → 15 líneas internas como mínimo → la decodificación usa las 5 líneas altas A19…A15 (los bloques de 64K y 128K dejan libres A15/A16, que se usan para su selección individual). Ecuaciones (nivel activo = el indicado; en E/S la variable representada es la propia entrada CE̅ activa a nivel BAJO):
CE̅(ES2)= A19 + A18 + A17 + A16 + A15 (una OR de 5 entradas; =0 solo en 00000H–07FFFH).CE(RAM-A)(ALTO) = A̅19 · A̅18 · A17 → 20000H–3FFFFH.CE(RAM-B)(ALTO) = A̅19 · A18 · A̅17 → 40000H–5FFFFH.CE̅(ES1)= A̅19 + A18 + A17 + A16 (=0 solo con A19=1, A18=0, A17=0, A16=0, es decir 80000H–8FFFFH; A15 no interviene porque el bloque es de 64K).- Base PROM:
P = A19 · A18 · A17(sector E0000H–FFFFFH); los 4 CI de 32K se eligen con A16,A15 (se puede usar un decodificador 2–4 habilitado por P):CE(PROM3) = P·A̅16·A̅15,CE(PROM2) = P·A̅16·A15,CE(PROM1) = P·A16·A̅15,CE(PROM0) = P·A16·A15. - En los huecos (08000H–1FFFFH, 60000H–7FFFFH, 90000H–DFFFFH) ninguna señal se activa: no hay que decodificarlos.
Dibujar: CPU con A19–A0, D15–D0 y WE̅; A14–A0 a E/S-2 y a los 4 PROM; A15–A0 a E/S-1; A16–A0 a los 4 RAM; el bloque decodificador con las ecuaciones anteriores; el WE̅ de la CPU a las patillas WE de RAM, E/S-1 y E/S-2 (la PROM no lleva WE). En cada grupo de 2 RAM un CI conduce D7–D0 y el otro D15–D8 (comparten direcciones y CE); cada RAM completa (grupo) ocupa un sector de 128K.
📚 Teoría: Tema 5, pág. 34–35 del PDF «Tema 5 SD-II_20230215.pdf» — condiciones de habilitación de cada bloque del mapa según las líneas de dirección; el circuito de decodificación se realiza con puertas lógicas o estructura PLA. 📚 Teoría: Tema 1, pág. 3–5 del PDF «Tema 1 SD-II_20200206.pdf» — decodificador completo: n entradas y 2ⁿ salidas, entradas de habilitación, salidas activas a nivel alto o bajo, y generación de minitérminos sumados con OR.
c) Bonus: módulo VHDL de la decodificación
(no se pide este año, pero sí en años cercanos). Al repasar el módulo sobre el rango completo de las 20 líneas, cada CS debe salir exactamente en su rango, sin ningún solapamiento y con los huecos sin activar:
library IEEE;
use IEEE.STD_LOGIC_1164.ALL;
use IEEE.STD_LOGIC_UNSIGNED.ALL;

entity Decodificador_Map is
  port ( A       : in  std_logic_vector(19 downto 15);  -- 5 lineas altas
         CS_ES2  : out std_logic;                       -- 00000H-07FFFH, activa BAJO
         CS_ES1  : out std_logic;                       -- 80000H-8FFFFH, activa BAJO
         CS_RAM  : out std_logic_vector(1 downto 0);    -- grupo A(1)/B(0), activa ALTO
         CS_PROM : out std_logic_vector(3 downto 0) );  -- 4 CI de 32K, activa ALTO
end Decodificador_Map;

architecture Behavioral of Decodificador_Map is
  -- senal auxiliar DIR para referir las direcciones a las 20 lineas del bus
  signal DIR : std_logic_vector(19 downto 0);
begin
  DIR <= A & "000000000000000";   -- 5 bits altos + 15 ceros: DIR = base de cada bloque de 32K
  CS_ES2   <= '0' when DIR <= 16#07FFF# else '1';                    -- bloque 0
  CS_RAM(1) <= '1' when DIR >= 16#20000# and DIR <= 16#3FFFF# else '0'; -- RAM-A 20000H-3FFFFH
  CS_RAM(0) <= '1' when DIR >= 16#40000# and DIR <= 16#5FFFF# else '0'; -- RAM-B 40000H-5FFFFH
  CS_ES1   <= '0' when DIR >= 16#80000# and DIR <= 16#8FFFF# else '1';  -- E/S-1
  CS_PROM(3) <= '1' when DIR = 16#E0000# else '0';   -- E0000H-E7FFFH
  CS_PROM(2) <= '1' when DIR = 16#E8000# else '0';   -- E8000H-EFFFFH
  CS_PROM(1) <= '1' when DIR = 16#F0000# else '0';   -- F0000H-F7FFFH
  CS_PROM(0) <= '1' when DIR = 16#F8000# else '0';   -- F8000H-FFFFFH
end Behavioral;
Notas: es la forma de la transparencia (Tema 5, pág. 36): auxiliar DIR por
concatenación de los bits altos con ceros y comparaciones de rango con notación
hexadecimal 16#…#. Las ecuaciones booleanas puerta a puerta (suma/producto de las
5 líneas) dan exactamente el mismo mapa: puedes escribirlas como justificación en la
tabla, pero el módulo se redacta así. Los huecos (08000H-1FFFFH, 60000H-7FFFFH,
90000H-DFFFFH) no activan ninguna señal: ninguna comparación los cubre.
📚 Teoría: Tema 5, pág. 36–37 del PDF «Tema 5 SD-II_20230215.pdf» — descripción VHDL de la decodificación del mapa de memoria (dos versiones). 📚 Teoría: Tema 1, pág. 33–34 del PDF «Tema 1 SD-II_20200206.pdf» — decodificador de 3 a 8 líneas en VHDL y su variante con línea de enable (EN) activa a nivel alto: como el bloque P·A16A15 que habilita los 4 CI de 32K.
Errores típicos — P3
- Usar 16 líneas de dirección: 1M posiciones = 20 líneas A19–A0; el bus de datos de 16 bits no limita el espacio. Mapa completo: 00000H–FFFFFH.
- Buscar un único CS para la RAM de 256K: empieza en 20000H (no alineado a 40000H) → hay dos habilitaciones de 128K. Si se ignora, la selección solapa el hueco 08000H–1FFFFH.
- PROM "detrás de la RAM": el enunciado dice termina al final del mapa → E0000H–FFFFFH; los huecos quedan entre bloques (compruébalo, es parte de la tabla).
- RAM sin expansión de bits: 128K×8 no llena el bus de 16 → 4 CI, no 2. Es lo primero que se comprueba. PROM: 4 CI, no 1.
- Confundir polaridades: E/S con CE̅ (BAJO) y memorias con CE (ALTO); la ecuación de
un CE̅ es la suma (OR) de las líneas, la de un CE es el producto. Un
notde más invierte el mapa entero: repasando los rangos de cada CS es de los primeros errores en verse (fallarían casi todas las direcciones). - Decodificar los huecos: no hace falta ninguna señal para ellos.
- Olvidar WE̅ en RAM y E/S (la PROM no lleva WE).
Esquema-resumen de la metodología
- Derivar las líneas de dirección del nº de posiciones, no del bus de datos — 1M posiciones = 2²⁰ → 20 líneas A19…A0 y mapa 00000H–FFFFFH (hex de 5 dígitos); el bus de datos de 16 bits no reduce el espacio (trampa: no usar 16 líneas).
- Comprobar cabida y coherencia antes de dibujar — tamaños en hex (128K=20000H, 256K=40000H, 64K=10000H, 32K=8000H); suma usada 128K+256K+64K+32K = 480K ≤ 1024K ✔; las posiciones del enunciado 20000 y 80000, sin sufijo H, son hex por contexto (se piden las direcciones en hexadecimal) y caen dentro del mapa.
- Colocar los bloques donde el enunciado los fija y anclar la PROM al final — E/S-2 (32K) al principio (00000H), RAM (256K) en 20000H, E/S-1 (64K) en 80000H; la PROM de 128K termina en FFFFFH → empieza en 100000H − 20000H = E0000H.
- Rellenar la tabla con inicial, final y polaridades, y deducir sumando los tres huecos — hueco 08000H–1FFFFH (96K), hueco 60000H–7FFFFH (128K) y hueco 90000H–DFFFFH (320K); los huecos no están impresos, se deducen, y el total encaja: 480K usados + 544K libres = 1M exacto, sin solapes; los huecos no se decodifican.
- Detectar la trampa de alineación de la RAM antes de elegir las CS — una RAM de 256K exigiría empezar en múltiplo de 40000H y 20000H no lo es: no existe un único CS de 256K, la selección se hace por dos sectores de 128K (RAM-A 20000H–3FFFFH y RAM-B 40000H–5FFFFH); la PROM en cambio cae exacta en el sector 111 (E0000H–FFFFFH).
- Contar los CI con expansión de palabras × bits — PROM 128K×16 con CI de 32K×16: 4 en cascada (1 etapa de bits); RAM 256K×16 con CI de 128K×8: 2 grupos de 128K con 2 CI en paralelo cada uno (uno D7–D0, otro D15–D8) → 4 CI, no 2; E/S son módulos hechos, 1 + 1.
- Decodificar con las 5 líneas altas A19–A15 y la polaridad de cada bloque — el bloque más pequeño mide 32K → 15 líneas internas como mínimo; cada CE̅ (E/S, nivel BAJO) es una OR de las líneas que se anula solo en su rango, y cada CE (RAM y PROM, nivel ALTO) es un producto; los 4 CI de la PROM se eligen con la base P = A19·A18·A17 más A16,A15 (decodificador 2–4 habilitado por P).
- Dibujar el diagrama lógico con las líneas internas correctas y el WE̅ — A14–A0 a E/S-2 y a los 4 PROM, A15–A0 a E/S-1, A16–A0 a los 4 RAM; WE̅ de la CPU a las patillas WE de RAM, E/S-1 y E/S-2 (la PROM no lleva WE); en cada grupo de 2 RAM comparten direcciones y CE y se reparten D7–D0 / D15–D8.
- Bonus VHDL de la decodificación (no se pide este año, sí en años cercanos) — módulo con auxiliar
DIR(bits altos concatenados con ceros) y una comparaciónwhen … elsepor CS con notación16#…#(forma de Tema 5 pág. 36); al repasar el rango completo de las 20 líneas, cada CS debe salir exactamente en su rango, sin solapamientos y con los huecos sin activar.
Idea transversal: el orden impuesto (E/S-2 al principio, RAM en 20000H, E/S-1 en 80000H) y el anclaje de la PROM al final fijan el mapa sin decisiones — rangos y huecos salen de sumar en hex, no a ojo; la alineación decide la granularidad de la selección (RAM de 256K desalineada a 40000H → dos CS de 128K) y la polaridad decide la forma de cada ecuación (CE̅ = suma OR, CE = producto AND); el conjunto se valida repasando todo el espacio: sin solapes y sin señal en los huecos.
Problema 4 — CPU von Neumann: microoperaciones y unidad de control (2,5 puntos)
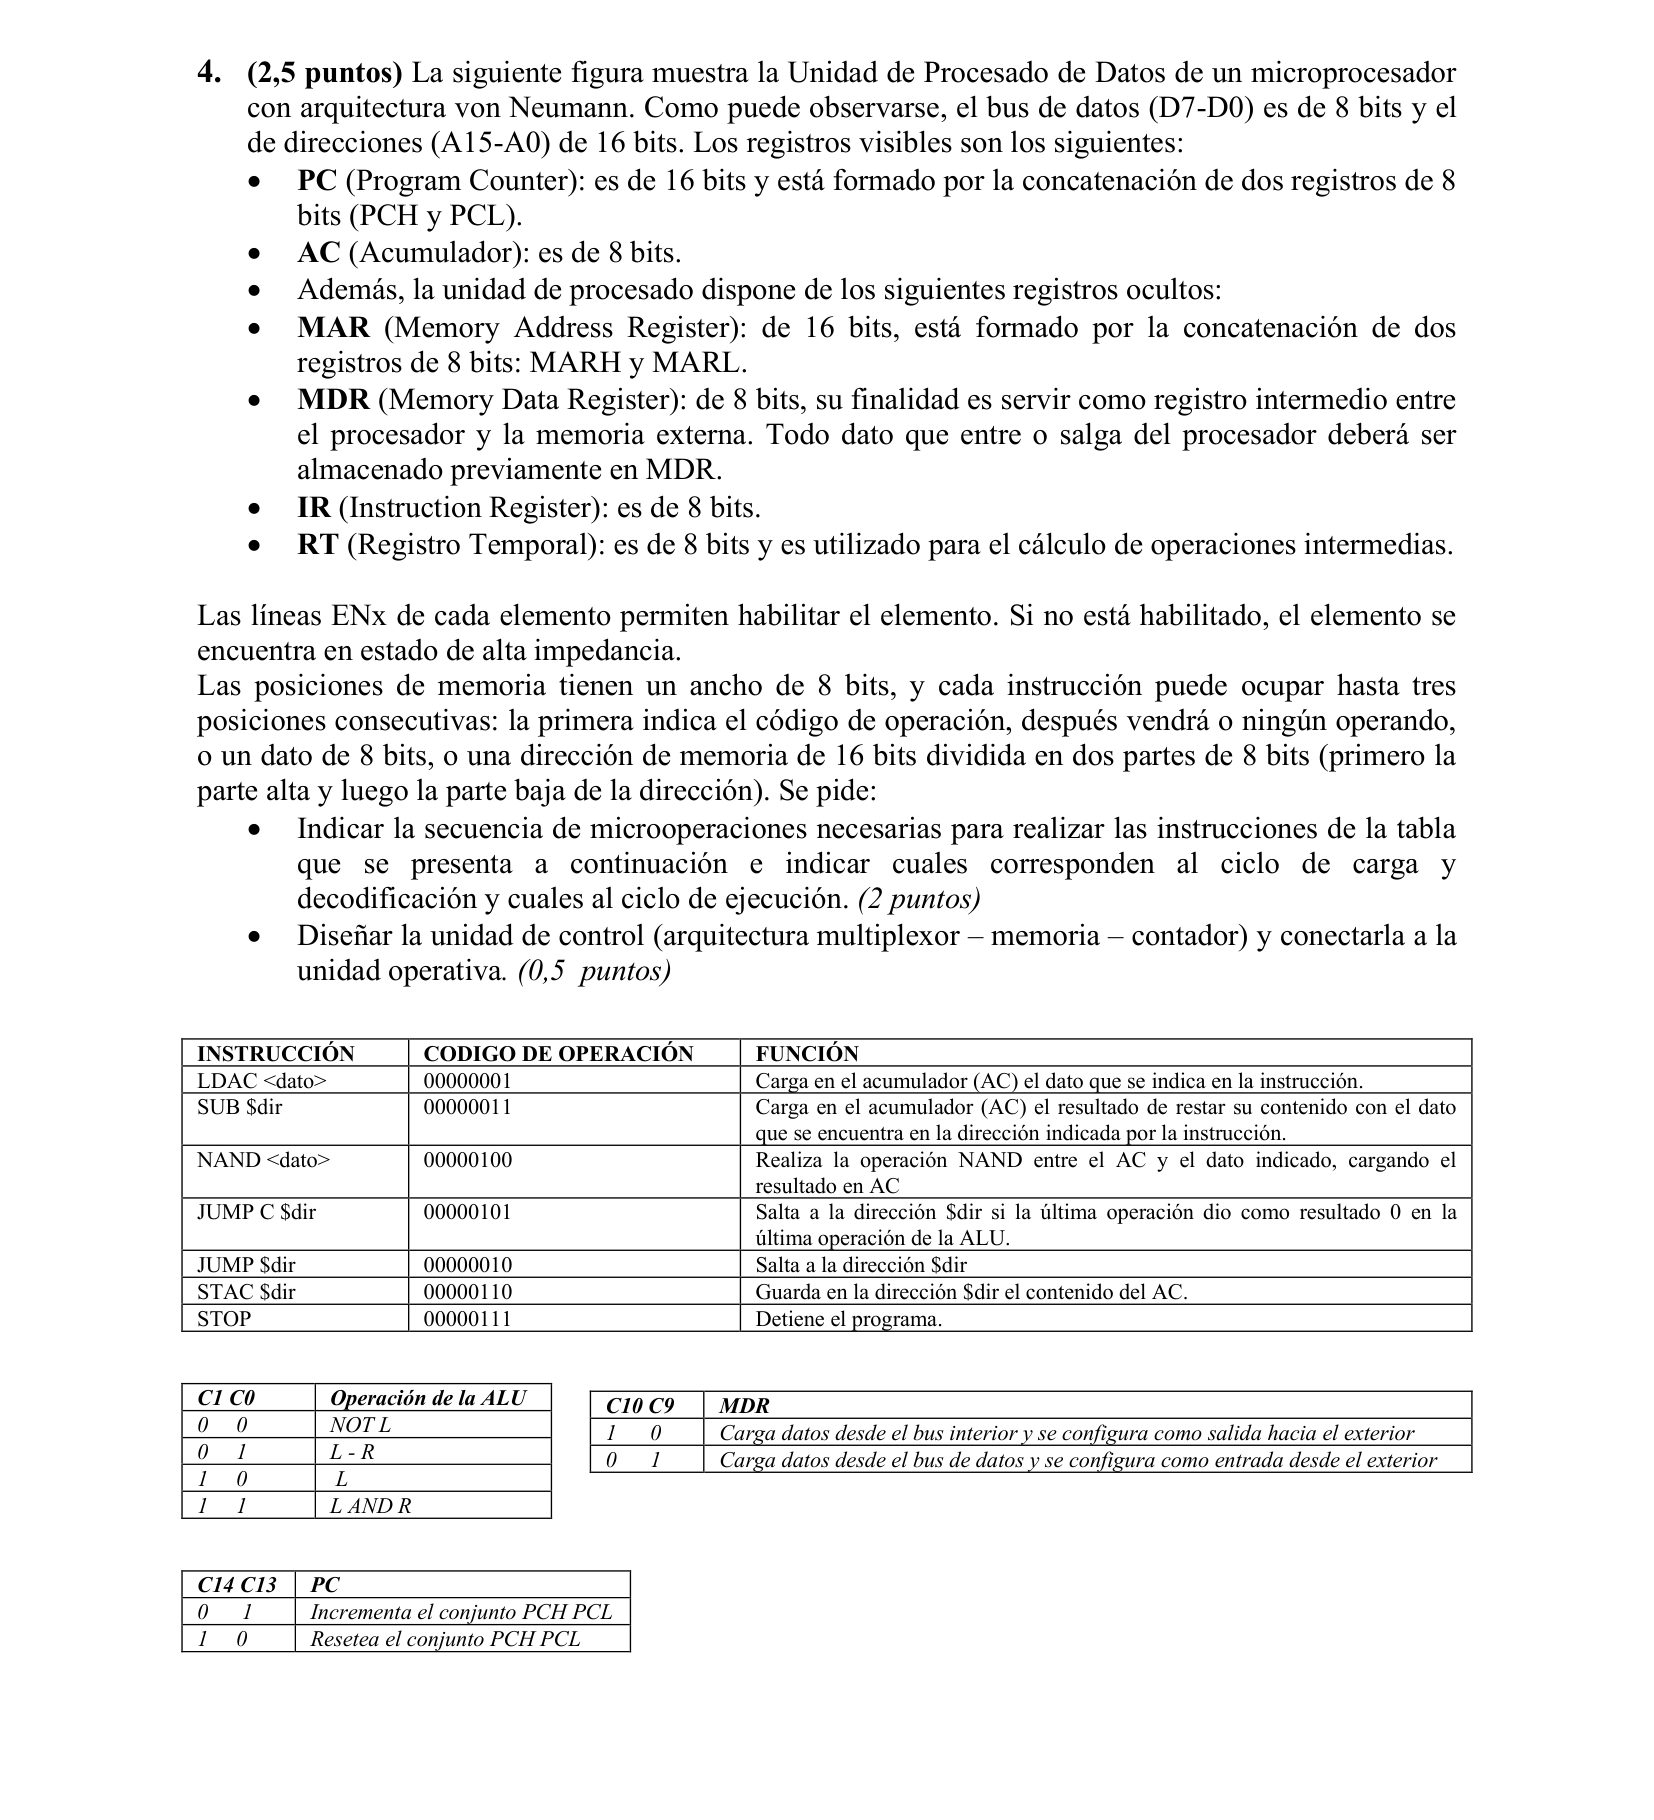
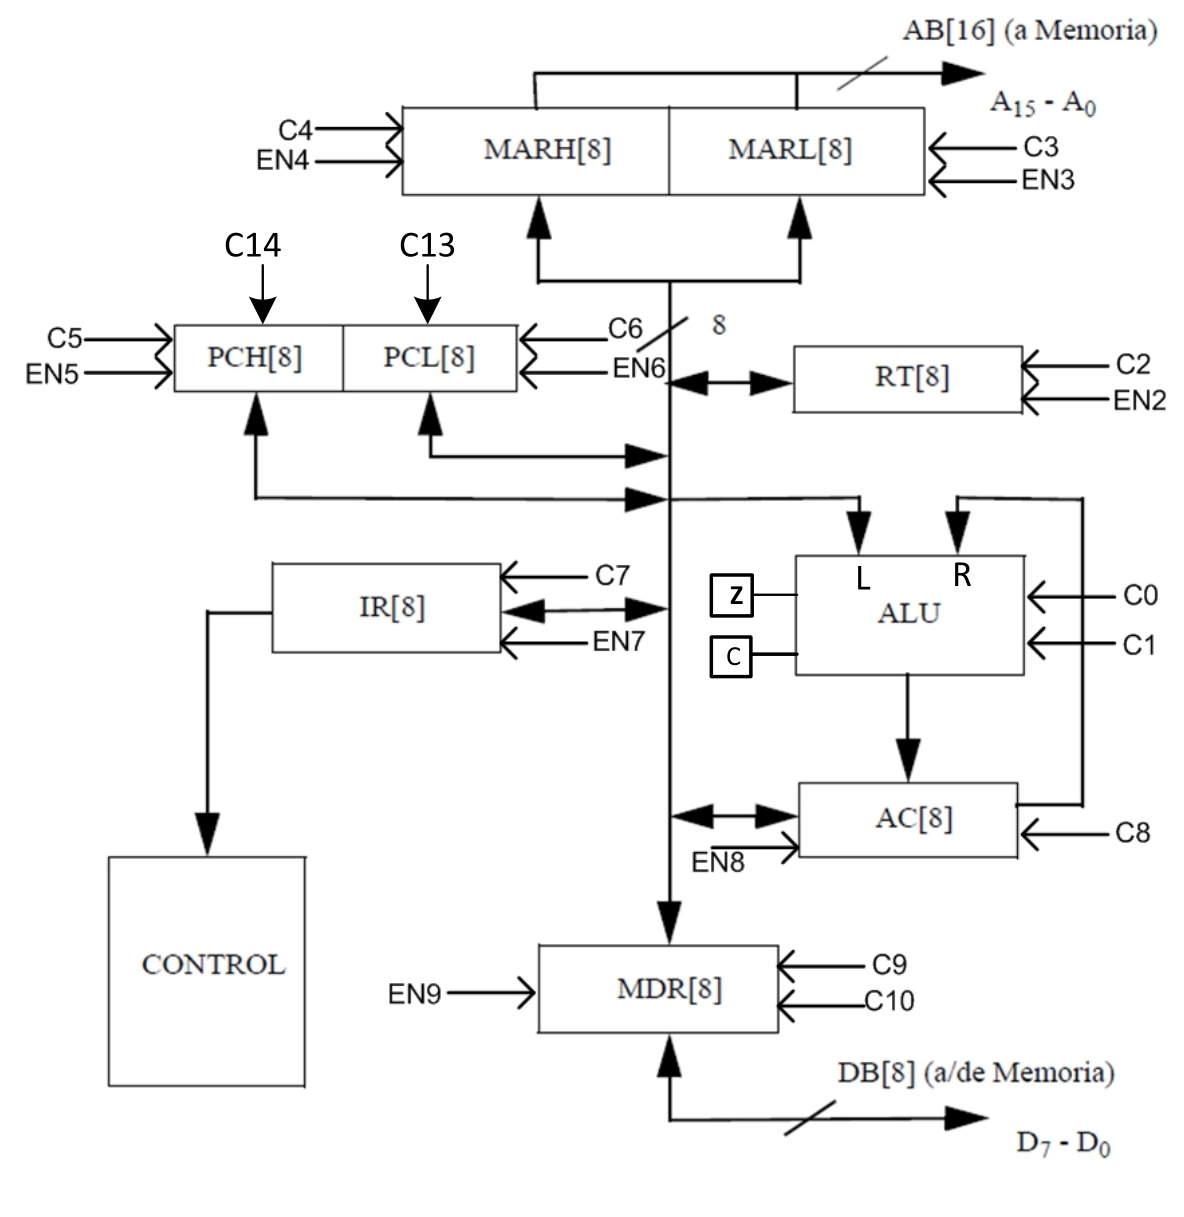
Planteamiento. La Unidad de Procesado transfiere datos por un bus interior de 8 bits (un único bus, troncal en la figura): la línea ENx de cada elemento habilita su salida al bus (sin habilitar, alta impedancia) y su señal Cx paralela le carga desde el bus. El ciclo de carga+decodificación es idéntico para todas las instrucciones (PC→MAR, lectura de memoria→MDR→IR) y ocupa los 4 primeros micro-pasos; la ejecución varía: las instrucciones de 2 bytes leen el dato (LDAC carga un dato inmediato de la posición siguiente al opcode) y las de dirección de 16 bits la montan en MAR byte a byte — primero la parte alta, luego la baja — con RT como puente del byte alto. El microprograma presentado ocupa 51 microinstrucciones (00H–32H ≤ 64: justifica el MPC de 6 bits del diseño de la UC).
Baremo: microoperaciones por instrucción 2 p · diseño y conexión de la UC 0,5 p.
Datos que fija el enunciado (y su figura) y decisiones de diseño. La figura fija el bus exterior de direcciones AB[16] (A15–A0) desde MAR hacia la memoria y el bus de datos DB[8] (D7–D0) unido al MDR; los bloques dibujados MARH[8] | MARL[8] (arriba, hacia AB), PCH[8] | PCL[8], RT[8], IR[8], ALU, AC[8] y MDR[8], cada uno con su par real ENx/Cx en la figura: EN2/C2 = RT, EN3/C3 = MARL, EN4/C4 = MARH, EN5/C5 = PCH, EN6/C6 = PCL, EN7/C7 = IR, EN8/C8 = AC, EN9 con C9C10 = MDR. Fija también la tabla ALU C1C0: 00=NOT L, 01=L−R, 10=L, 11=L AND R, con Z y C como banderillas registradas en cajas separadas pegadas al borde izquierdo de la ALU — C no es un bus ni "la salida de la ALU" —, y el par C14C13: 01 incrementa PCH·PCL, 10 resetea (incrementador propio del PC, cable propio: no usa el bus interior). La tabla C10C9 del MDR: 01 carga desde DB (lectura de memoria), 10 carga desde el bus interior y lo configura como salida hacia la memoria (escritura). Fija el texto: registros ocultos MAR = MARH+MARL (16), MDR (8: intermedio obligatorio para todo dato que entre o salga del procesador), IR (8) y RT (8), y la ISA con códigos 00000001–00000111 y formatos (opcode + dato de 8, u opcode + dirección de 16 con la parte alta primero).
Tres detalles topológicos de la figura que determinan la solución y que el alumno tiende a suponer mal:
- La entrada L de la ALU es un ramal directo del bus interior y la entrada R es una línea directa del propio AC (punto de unión en el borde derecho del AC que sube hasta la ALU): L y R NO son registros cargables — no existen códigos de carga L/R y no tiene sentido escribir "L ← AC" ni "R ← MDR". La ALU ya "ve" siempre a AC por R; lo único que se elige desde el bus es L.
- La salida de la ALU carga únicamente AC (único cable de salida de la ALU): no hay ramal ALU→bus ni ALU→RT; por eso un "RT ← ALU" es imposible y el resultado de la ALU que necesite volver al bus debe antes quedar en AC (EN8).
- RT solo cuelga del bus (bidireccional): su papel es hacer de puente del byte alto de $dir (RT ← MDR y luego MARH ← RT).
Supuestos a declarar en el examen (la figura no los fija): que el incremento del PC
(C14C13) puede ejecutarse en paralelo con una carga de MDR precisamente porque
no usa el bus; que Z=1 cuando la última operación de la ALU dio 0 y se actualiza
en cada captura de la ALU y que C es el banderín de acarreo de la ALU (la figura
dibuja los dos banderines en cajas separadas y no fija ni cuándo actualiza cada uno ni
la polaridad de C: decláralo — C=1 cuando la operación aritmética produce acarreo);
que la escritura a memoria externa necesita un pulso WE̅ que la figura no dibuja
(genéralo tú en STAC); y dos chapuzas de redacción de la tabla ISA, leídas como las
lee la solución oficial del examen: (a) JUMP C $dir dice en su FUNCIÓN «salta si
la última operación dio como resultado 0», pero su nombre es jump if carry: decide
C, no el cero (un salto que dependiera del cero no sería un salto por acarreo);
(b) SUB $dir reza «restar su contenido con el dato de $dir» — mal expresado,
significa restar el dato al contenido: AC ← AC − M[$dir], la convención
habitual del acumulador, y así lo escribe la solución oficial (AC ← AC − MDR).
Decisiones
de diseño: los 4 primeros micro-pasos del fetch son comunes, y el dato NAND se hace
en dos pasos de ALU sin registro intermedio (la tabla no tiene NAND): primero
AC ← dato AND AC (L=MDR al bus, R=AC) y después AC ← NOT AC (L=AC al bus).
Ciclo de carga y decodificación (común a todas las instrucciones)
Tras cada instrucción el PC apunta ya a la siguiente (los incrementos están contados en la ejecución):
| Paso | MC | Micro-operación | Control |
|---|---|---|---|
| T0 | 00H | MARH ← PCH | EN5, C4 |
| T1 | 01H | MARL ← PCL | EN6, C3 |
| T2 | 02H | MDR ← M[MAR] y en paralelo PC ← PC+1 | C10C9=01; C14C13=01 |
| T3 | 03H | IR ← MDR (decodificación: el opcode va además a la UC y al vector de direcciones del microprograma) | EN9, C7; MPC ← vector(IR) |
📚 Teoría: Tema 4, pág. 8 del PDF «Tema 4 SD-II_20220512.pdf» — arquitectura Von Neumann: programa y datos en la misma memoria; ciclo obtener instrucción ← IR, actualizar PC, decodificar en la UC, ejecutar. 📚 Teoría: Tema 5, págs. 17–18 del PDF «Tema 5 SD-II_20230215.pdf» — microprograma simbólico de un procesador sencillo: fetch idéntico en todas las instrucciones (MAR ← PC; IR ← M(MAR), PC ← PC+1) y dispatch por código de operación.
Secuencias de ejecución por instrucción
El número MC de cada paso es la posición que ocupa en la memoria de control (microprograma de la tabla final): micro-operación ↔ posición MC, 1:1.
(1) LDAC <dato> (00000001) — 2 bytes, dato inmediato. Ejecución 04H–07H:
| Paso | MC | Micro-operación |
|---|---|---|
| E0 | 04H | MARH ← PCH (EN5, C4) — el PC ya apunta al dato |
| E1 | 05H | MARL ← PCL (EN6, C3) |
| E2 | 06H | MDR ← M[MAR] (el dato) ; PC ← PC+1 (C10C9=01; C14C13=01) |
| E3 | 07H | AC ← MDR (EN9, C8) ; fin → fetch |
(2) JUMP $dir (00000010) — 3 bytes (dir alta, dir baja). Ejecución 08H–0EH:
| Paso | MC | Micro-operación |
|---|---|---|
| E0 | 08H | MARH ← PCH (EN5, C4) |
| E1 | 09H | MARL ← PCL (EN6, C3) |
| E2 | 0AH | MDR ← M[MAR] (dir ALTA) ; PC ← PC+1 |
| E3 | 0BH | PCH ← MDR (EN9, C5) — la dir alta en su sitio; el MAR aún sirve para leer el bajo |
| E4 | 0CH | MARL ← PCL (EN6, C3) — posición de la dir baja (MARH intacto) |
| E5 | 0DH | MDR ← M[MAR] (dir BAJA), sin PC+1 (el PCL destino se destruiría después) |
| E6 | 0EH | PCL ← MDR (EN9, C6) → PC = $dir ; fin → fetch |
(3) SUB $dir (00000011) — 3 bytes. Monta la dirección del operando en MAR con RT de puente del byte alto y calcula AC − dato:
| Paso | MC | Micro-operación |
|---|---|---|
| E0 | 0FH | MARH ← PCH |
| E1 | 10H | MARL ← PCL |
| E2 | 11H | MDR ← M[MAR] (byte alto de $dir) ; PC ← PC+1 |
| E3 | 12H | RT ← MDR (EN9, C2) — guarda la parte alta |
| E4 | 13H | MARL ← PCL (PC+1 = posición de la parte baja) |
| E5 | 14H | MDR ← M[MAR] (parte baja de $dir) |
| E6 | 15H | MARH ← RT (EN2, C4) |
| E7 | 16H | MARL ← MDR (EN9, C3) → MAR = $dir completo |
| E8 | 17H | MDR ← M[MAR] (lee el dato M[$dir]) |
| E9 | 18H | AC ← AC − MDR: EN9 (el dato en MDR al bus), C1C0=01 (resta, minuendo = AC, igual que la solución oficial) ; PC ← PC+1 ; actualiza Z y C ; fin → fetch |
Lectura de la instrucción (criterio de la solución oficial): «restar su contenido con
el dato de $dir» está mal expresado, pero significa que la resta se hace al
contenido: AC ← AC − M[$dir]; la solución oficial lo escribe tal cual (AC ← AC −
MDR, línea 26 de su microprograma). Si alguien tomara la otra lectura literal
(dato − AC), debe declararla expresamente — la secuencia de micro-pasos no cambia ni
un ápice.
(4) NAND <dato> (00000100) — 2 bytes. La tabla C1C0 no tiene NAND → AND+NOT en
dos pasos sin necesidad de registro intermedio (R es siempre AC). Ejecución 19H–1DH:
| Paso | MC | Micro-operación |
|---|---|---|
| E0 | 19H | MARH ← PCH |
| E1 | 1AH | MARL ← PCL |
| E2 | 1BH | MDR ← M[MAR] (el dato) ; PC ← PC+1 |
| E3 | 1CH | AC ← dato AND AC: EN9 (L = dato), R = AC, C1C0=11 |
| E4 | 1DH | AC ← NOT AC: EN8 (L = AC en el bus), C1C0=00 ; actualiza Z ; fin → fetch |
No escribas «RT ← ALU» ni «L ← AC, R ← MDR»: no hay cable ALU→RT ni cargas L/R (errores típicos).
(5) JUMP C $dir (00000101) — 3 bytes. Salta si C=1 (acarreo de la ALU: el nombre de la instrucción manda sobre el «dio 0» chapucero de la FUNCIÓN). Lee la dirección sin tocar la ALU para no destruir C. Ejecución 1EH–27H:
| Paso | MC | Micro-operación |
|---|---|---|
| E0 | 1EH | MARH ← PCH |
| E1 | 1FH | MARL ← PCL |
| E2 | 20H | MDR ← M[MAR] (dir ALTA) ; PC ← PC+1 |
| E3 | 21H | RT ← MDR (EN9, C2) — dir alta en espera; NO se carga PCH todavía: si C=0 hay que seguir el PC |
| E4 | 22H | MARL ← PCL |
| E5 | 23H | MDR ← M[MAR] (dir BAJA) ; PC ← PC+1 (deja el PC tras la instrucción por si C=0) |
| E6 | 24H | bifurcación: SEL=001, A=25H → MPC ← 25H + C: si C=0 cae en 25H (micro-op de paso vacío, SEL=100 → fetch: el PC ya sumó los 3) ; si C=1 salta a 26H |
| C=1 | 26H | PCH ← RT (EN2, C5) |
| C=1 | 27H | PCL ← MDR (EN9, C6) → PC = $dir ; fin → fetch |
(6) STAC $dir (00000110) — 3 bytes. Igual que SUB hasta MAR=$dir, y escribe. Ejecución 28H–31H:
| Paso | MC | Micro-operación |
|---|---|---|
| E0–E7 | 28H–2FH | idénticos a SUB E0–E7 (MAR ← $dir montado con RT de puente; sin leer M[$dir]: aquí no hace falta) |
| E8 | 30H | MDR ← AC (EN8 + C10C9=10: carga desde el bus interior y salida hacia la memoria) |
| E9 | 31H | M[MAR] ← MDR (pulso de escritura WE̅) ; PC ← PC+1 ; fin → fetch |
(7) STOP (00000111) — 1 byte. Tras el fetch (T0–T3, PC+1), posición 32H: el microprograma entra en un bucle sin señales (SEL=010, A=32H: el MPC se auto-salta a sí mismo); la unidad operativa queda inactiva hasta un reset.
Claves (puntos del apartado): separar siempre el fetch común (los 4 primeros micro-pasos: "cuáles pertenecen a carga/decodificación") de la ejecución; montar la dirección de 16 bits en dos lecturas consecutivas con RT de puente; en JUMP C no usar la ALU y decidir sobre C; NAND en dos pasos sin RT; contar los incrementos de PC (el PC debe sumar 1, 2 o 3 según la longitud: STOP 1; LDAC/NAND 2 —T2+E2, sin PC+1 final—; JUMP C no tomado y SUB/STAC 3; en JUMP puro da igual porque PC se carga con $dir).
Diseño de la unidad de control: multiplexor – memoria de control – contador (0,5 p)
Componentes y conexión (dibujar):
- MPC: contador de 6 bits (51 microinstrucciones ≤ 64) con carga por el MUX y reset a 00H.
- MC (memoria de control): 64 palabras de 24 bits, direccionada por MPC; ROM o PLA. CMBR: registro buffer de la palabra de microinstrucción (Tema 5, pág. 5).
- Palabra de control (24 bits):
| Campo | Bits | Contenido |
|---|---|---|
| SRC | 4 | selector de la línea ENx activa (códigos = números de la figura): 0000=bus flotante, 0010=RT, 0011=MARL, 0100=MARH, 0101=PCH, 0110=PCL, 0111=IR, 1000=AC, 1001=MDR |
| DEST | 4 | registro que carga desde el bus: 0000=ninguno, 0010=RT, 0011=MARL, 0100=MARH, 0101=PCH, 0110=PCL, 0111=IR, 1000=AC desde el bus; 1001=AC capturando la salida de la ALU (único destino posible de la ALU; 1000 y 1001 nunca a la vez) |
| C1C0 | 2 | operación ALU (00, 01, 10, 11 de la figura) |
| C10C9 | 2 | MDR: 00 inactivo, 01 lectura externa→MDR, 10 bus→MDR hacia memoria |
| C14C13 | 2 | PC: 00 nada, 01 incrementa, 10 reset |
| WE | 1 | pulso de escritura a la memoria externa (supuesto declarado) |
| SEL | 3 | 000 MPC+1 · 001 MPC←A+C (bifurcación condicional JUMP C) · 010 MPC←A (salto absoluto; STOP se auto-salta) · 011 MPC←vector(IR) (fin de decodificación) · 100 MPC←000H (empieza el siguiente fetch) |
| A | 6 | dirección de salto para SEL=001/010 (anchura = tamaño del microprograma) |
- Conexión con la unidad operativa: el campo SRC pasa por un decodificador que
genera las líneas EN2–EN9 (una activa por microinstrucción); DEST genera las
cargas C2–C8 más la captura ALU→AC; C1C0/C10C9/C14C13/WE van directas a la ALU,
MDR, PC y memoria externa. Entradas externas de la UC: C (flag de acarreo de
la ALU, para el MUX A+C; Z queda disponible pero no la consume ninguna
bifurcación, porque en esta ISA el único salto condicional es
JUMP C) y IR(2:0) por la mini-ROM de 8 entradas que genera el vector opcode→dirección (la propia microinstrucción 03H ejecuta SEL=011). La propia palabra en CMBR devuelve SEL y A al MUX de siguiente dirección.
Mapa del microprograma (51 microinstrucciones, 00H–32H) y vector de códigos:
| Instrucción | Dirección en MC | Nº micro-op. ejecución |
|---|---|---|
| Fetch (T0–T3) | 00H–03H | — (común) |
| LDAC (01H) | 04H–07H | 4 |
| JUMP (02H) | 08H–0EH | 7 |
| SUB (03H) | 0FH–18H | 10 |
| NAND (04H) | 19H–1DH | 5 |
| JUMP C (05H) | 1EH–27H | 7 + 3 de bifurcación |
| STAC (06H) | 28H–31H | 10 |
| STOP (07H) | 32H (bucle SEL=010, A=32H) | 1 |
Vector código→dirección (campo SEL=011 en la micro-instrucción 03H):
01H→04H, 02H→08H, 03H→0FH, 04H→19H, 05H→1EH, 06H→28H, 07H→32H (IR = 0000_0xxx:
los 3 bits bajos del opcode direccionan una mini-ROM/PLA de 8 entradas que alimenta
el MUX de siguiente dirección del MPC).
Ejemplo de micro-instrucciones codificadas (fila = dirección MC):
| MC | SRC | DEST | C1C0 | C10C9 | C14C13 | WE | SEL | A | Palabra (hex) | Acción |
|---|---|---|---|---|---|---|---|---|---|---|
| 00H | PCH | MARH | — | — | — | 0 | 000 | — | 540000H | MARH←PCH |
| 02H | — | — | — | 01 | 01 | 0 | 000 | — | 001400H | MDR←M y PC+1 |
| 03H | MDR | IR | — | — | — | 0 | 011 | — | 9700C0H | IR←MDR; MPC←vector(IR) |
| 07H | MDR | AC | — | — | — | 0 | 100 | — | 980100H | AC←MDR; fetch siguiente |
| 18H | MDR | AC(ALU) | 01 | — | 01 | 0 | 100 | — | 994500H | AC←AC−MDR; PC+1 (fin SUB) |
| 24H | — | — | — | — | — | 0 | 001 | 25H | 000065H | MPC←25H+C: C=0→25H (no tomado), C=1→26H (PCH←RT) |
| 32H | — | — | — | — | — | 0 | 010 | 32H | 0000B2H | STOP: bucle sin señales |
📚 Teoría: Tema 5, págs. 4–6 del PDF «Tema 5 SD-II_20230215.pdf» — estructura de la unidad de control microprogramada: MPC, memoria de control, registro CMBR, campo de selección de condiciones y direcciones de salto (tabla de codificación tipo SEL). 📚 Teoría: Tema 5, pág. 9 del PDF «Tema 5 SD-II_20230215.pdf» — dimensionado de la UC: el tamaño de sus elementos viene condicionado por el tamaño del microprograma, las señales de control y las condiciones a comprobar (justifica MPC de 6 bits y palabra de 24). 📚 Teoría: Tema 5, pág. 16 y 21 del PDF «Tema 5 SD-II_20230215.pdf» — hardware que decodifica el código de operación de la instrucción; microprograma binario: contenido exacto de la memoria de control por posiciones.
Errores típicos — P4
- No separar claramente el ciclo de carga/decodificación (T0–T3 comunes) del de ejecución: es literalmente lo que pide el enunciado (2 p por el desglose).
- Inventarse registros L y R cargables o cables ALU→bus/ALU→RT: en la figura L es un ramal del bus, R es una línea directa del AC y la única salida de la ALU carga AC. Escribir «L ← AC», «R ← MDR» o «RT ← ALU» son contradiciones con la figura (errores de manual de este ejercicio). El NAND se hace en dos pasos directos a AC, sin RT.
- Olvidar que la dirección de 16 bits llega en dos bytes (alta primero) y montar MAR en un solo paso: hacen falta 2 lecturas + RT de puente (E3 y E6–E7).
- En JUMP C usar la ALU antes de la decisión y destruir C; o decidir con el flag Z porque la FUNCIÓN hable de «dio 0»: el nombre de la instrucción manda (C) — un jump if carry no puede depender del cero (la descripción es una chapuza del enunciado, no una condición distinta).
- No declarar la lectura de SUB: «restar su contenido con el dato» está mal
expresado y se lee AC ← AC − M[$dir] (minuendo = AC; la solución oficial escribe
AC ← AC − MDR); si se toma la otra lectura literal (dato − AC), hay que declararla expresamente. - PC+1 de más al final de LDAC/NAND (instrucciones de 2 bytes: el PC ya sumó en T2 y en E2). Haz el recuento: el PC debe sumar 1, 2 o 3 según la instrucción; si sobra uno, el siguiente fetch arranca a mitad de instrucción.
- Escribir "MDR←AC" a secas en STAC: hay que indicar C10C9=10 (salida al exterior) y el pulso de escritura a memoria en un paso distinto. Nunca cargar AC desde el bus y capturar la ALU en el mismo micro-ciclo (doble escritura de AC).
- Olvidar MDR como intermedio: IR solo puede cargar desde MDR, y todo dato exterior entra o sale por MDR.
- Dimensionar mal el MPC: el microprograma completo son 51 micro-instrucciones (00H–32H) → MPC de 6 bits y MC de 64 palabras; justifica la anchura del campo A (6 bits).
- No conectar el campo SEL/condiciones: la UC necesita el vector opcode→dirección y la línea C para el salto condicional; si falta, no hay decodificación ni bifurcación.
Esquema-resumen de la metodología
- Leer la figura y declarar lo que no fija — registros dibujados MARH|MARL, PCH|PCL, RT, IR, ALU, AC y MDR con sus pares ENx/Cx reales (EN2/C2=RT … EN9/C10=MDR), ALU con L del bus y R línea directa de AC, salida de la ALU solo a AC, Z y C como banderillas en cajas, C14C13 incrementador propio del PC; declarar los supuestos: el incrementador no usa el bus (por eso el PC+1 va en paralelo con una carga de MDR), Z=1 cuando la última operación de la ALU dio 0 y C es el acarreo de la ALU, el pulso WE̅ lo generas tú,
JUMP Cse decide por C (el nombre manda sobre la FUNCIÓN mal redactada) y SUB se lee AC ← AC − M[$dir] (redacción chapucera: la resta se hace al contenido). - Separar el ciclo común de carga+decodificación de la ejecución (2 p por el desglose) — idéntico para todas las instrucciones y en los 4 primeros micro-pasos: T0 MARH←PCH (EN5,C4), T1 MARL←PCL (EN6,C3), T2 MDR←M[MAR] y PC←PC+1 en paralelo (C10C9=01; C14C13=01), T3 IR←MDR (EN9,C7) con el código yendo además a la UC.
- Seguir el formato de la instrucción byte a byte — 1 byte (STOP) termina en el propio fetch; 2 bytes leen el dato inmediato en los pasos siguientes (E0–E3); 3 bytes montan la dirección de 16 leyendo dos veces, con la parte alta primero.
- Montar la dirección en MAR byte a byte con RT de puente — en SUB y STAC: RT←MDR (EN9,C2) guarda el byte alto y al final MARH←RT y MARL←MDR completan MAR=$dir; en JUMP sin condición se carga PCH primero (E3) y PCL al final (E6), con MARL←PCL intermedio, porque cargar PCL antes destruiría la dirección de lectura del byte bajo.
- Contar los incrementos del PC según la longitud — 1 (STOP), 2 (LDAC/NAND: T2+E2, sin PC+1 final — error clásico añadirlo) o 3 (JUMP C no tomado: T2+E2+E5; SUB/STAC: T2+E2+paso final); en JUMP puro PC ← $dir y el recuento da igual.
- Montar NAND en dos pasos de ALU sin RT — la tabla C1C0 no tiene NAND y no hay cable ALU→RT: con EN9 (dato en el bus, L) y R=AC, C1C0=11 captura AC ← dato AND AC; después con EN8 (AC al bus) C1C0=00 captura AC ← NOT AC (actualiza Z).
- Decidir JUMP C sobre C sin tocar la ALU — el nombre de la instrucción (jump if carry) manda sobre la FUNCIÓN mal redactada («si la última operación dio como resultado 0»; comentarlo en el examen); la bifurcación se hace en MC con SEL=001 y MPC ← A+C (C=0 sigue el camino recto con el PC ya sumado; C=1 salta a PCH←RT, PCL←MDR → PC=$dir).
- Marcar la escritura de STAC con los códigos del MDR y en pasos separados — MDR←AC exige C10C9=10 (carga desde el bus interior y salida hacia la memoria) y después M[MAR]←MDR con el pulso WE̅, en un micro-ciclo distinto; E0–E7 son idénticos a SUB hasta MAR=$dir.
- Dimensionar y dibujar la UC (multiplexor–memoria de control–contador) — el microprograma completo son 51 microinstrucciones ≤ 64 → MPC de 6 bits y MC (ROM/PLA) de 64 palabras × 24 bits, lo que justifica también la anchura del campo A; palabra de 24: SRC (4 bits, decodificado a las líneas EN2–EN9 con códigos = números de la figura), DEST (4 bits, señales de carga C2–C8 más captura ALU→AC), C1C0/C10C9/C14C13/WE directos a ALU, MDR, PC y memoria, SEL (3) y A (6) al multiplexor de siguiente dirección (MPC+1, A+C para el condicional, A absoluta —STOP se auto-salta en 32H—, vector(IR) al acabar la decodificación, 000H para el siguiente fetch); la UC recibe IR(2:0) por la mini-ROM de 8 entradas del vector y C para la bifurcación.
Idea transversal: todo cuelga del microprograma: el fetch es idéntico en todas las instrucciones, la dirección de 16 bits se monta en dos lecturas byte a byte con RT de puente, y el dimensionado de la UC (MPC de 6 bits, MC de 64×24) sale de contar las 51 microinstrucciones y las señales de control; la topología manda sobre la intuición (L del bus, R del AC, la ALU solo carga AC — de ahí el NAND en dos pasos y el «RT ← ALU» imposible), y cuando el mnemonic y la descripción discrepan manda el nombre de la instrucción sobre la redacción chapucera (JUMP C decide sobre C; SUB resta el dato al contenido de AC).