Guía de resolución — Examen de Sistemas Digitales II, Julio 2024 (10-07-2024)
Guía modelo para preparar la convocatoria de nov-dic 2026. El examen tiene 3 problemas: vagoneta sobre raíles ASM + VHDL (4 p), CPU von Neumann — microoperaciones + unidad de control (4 p) y mapa de memoria de 64K posiciones con bus de 8 bits (2 p).
Estado de esta guía: 3 de 3 problemas publicados y verificados: vagoneta ASM + VHDL (P1, doble pasada GHDL estricto), microoperaciones y mapa.
Importante: el profesor no puntúa ejercicios mal planteados. Escribe siempre el planteamiento (2-3 frases) antes de desarrollar, justifica cada elección y deja verificable el resultado final (tablas, direcciones, código).
Verificación de esta guía: los dos módulos VHDL (control de la vagoneta y
decodificador del mapa) están analizados y simulados con GHDL 4.1.0 --std=08
-fsynopsys. El controlador de la vagoneta (reescrito al estilo de los apuntes: proceso
único con wait until clk='1', reset síncrono, contador en vectores) pasa un testbench
que solo observa puertos: con la pre-escala reducida PRE=9 (10 flancos/tick) la espera
de E mide exactamente (PRE+1)·150 + 2 = 1502 flancos las dos veces que se dispara —
sin restos del contador tras un reset a mitad—; a escala real (PRE = 999.999) eso son
150.000.002 flancos = 6,00000008 s (150.000.000 pulsos de cuenta + 2 de latencia de
registro; el barrido de linealidad en cuatro pre-escalas del TB anterior no se ha
re-ejecutado — ver notas). El decodificador del mapa se simuló barriendo las 64
combinaciones de A15–A10 (= todas las clases de dirección de 16 bits): las 9 señales
correctas, cero solapes. La secuencia de microoperaciones del problema 2 se ejecutó
sobre un modelo Python de la unidad de procesado con un programa test
(LDAC/ADD/MUL3/SUBR/RETS/STAC/JUMP Z tomado y no tomado/STOP): resultados, Z y PC
correctos paso a paso. Las cuentas hex están comprobadas programáticamente.
Supuestos declarados (figuras)
- P1: el enunciado en texto contiene todo; la figura solo muestra la vagoneta sobre los raíles con la rueda izquierda y su leva frente al sensor R. El texto no nombra la señal que hace girar la rueda (la tracción I/D desplaza la vagoneta, no gira la rueda): la llamaremos GIZQ / GDER y se declara en el examen. Si tu figura usa otros nombres, renombra — la estructura no cambia.
- P2: la figura de la Unidad de Procesado sí está incrustada en el PDF (jpeg en la pág. 2, idéntica píxel a píxel a la del examen de junio-2024): los pares EN/C concretos (EN2–EN11, C2–C14) y los cableados de la ALU están en el propio apartado del Problema 2, con los supuestos que hay que escribir en el examen (L transparente, captura ALU→AC, flag Z, pulso WE̅ a la memoria).
- P3: el texto da todos los datos. "Centro del mapa" = mitad de 64K = 8000H. Los módulos E/S son circuitos ya hechos de 2K×8 con sus entradas CE/WE; no se construyen con CIs de memoria.
Problema 1 — Vagoneta sobre raíles: ASM + VHDL (4 puntos)
Planteamiento. Es una ASM con la vagoneta parada esperando orden (único punto donde mandan los pulsadores, porque el enunciado dice que las pulsaciones con la vagoneta en movimiento se ignoran). E lanza una cuenta de 6 s y después un giro de la rueda izquierda a la izquierda; G lanza el mismo giro a la derecha (sin cuenta: el enunciado solo menciona los 6 s en E); F y H desplazan la vagoneta mientras se mantienen a nivel. Un giro "completo" exige dos estados porque el sensor R vale 1 en reposo: primero hay que alejar la leva del sensor (esperar R=0) y luego acercarla hasta volver a ver R=1. Los 6 s se generan con reloj de 25 MHz mediante dos contadores en cascada.
Baremo del enunciado: a) diagrama ASM con cálculos de la espera: 2,5 p · b) código VHDL del diagrama: 1,5 p.
Cálculo de la espera de 6 s a 25 MHz (imprescindible, va en el apartado a)
6 s × 25.000.000 pulsos/s = 150.000.000 pulsos
Se descompone en dos contadores en cascada:
| Etapa | Módulo | Cuenta con | Resultado | Bits necesarios |
|---|---|---|---|---|
| Pre-escala | MOD-1.000.000 | 25 MHz | 25 Hz (un pulso cada 40 ms) | 20 (2²⁰ = 1.048.576 ≥ 10⁶) |
| Contador de ticks | MOD-150 | 25 Hz | 150 × 40 ms = 6,00 s justos | 8 (2⁸ = 256 ≥ 150) |
Comprobación: 1.000.000 × 150 = 150.000.000 ✔ y 150·10⁶ / 25·10⁶ = 6 s ✔. Los contadores solo cuentan mientras la ASM está en ESPERA_6S (habilitación implícita por el estado) y se limpian al salir de ese estado. El nivel T (terminal de cuenta) pasa a 1 tras 150.000.000 pulsos y provoca la salida del estado.
Alternativa equivalente y válida: un único contador MOD-150.000.000 de 28 bits (2²⁸ = 268.435.456 ≥ 150·10⁶). La cascada 10⁶ × 150 es la que se usa en clase.
📚 Teoría: Tema 2, pág. 56–58 del PDF «Tema 2 SD-II_20200317.pdf» — contador síncrono con habilitación y borrado; asociación de contadores para obtener mayor módulo y, en particular, la asociación síncrona que «emplea las entradas y salidas de habilitación de cuenta» (igual que aquí: el contador de ticks avanza solo cuando la pre-escala completa su ciclo, con los dos flancos de reloj aplicados simultáneamente).
a) Diagrama ASM — 8 estados (2,5 p)
Bloques ASM (uno por estado; entre corchetes las salidas activas del estado; "sin transición" = permanecer; T = fin de los 6 s):
| # | Estado (bloque ASM) | Salida | Decisiones → siguiente estado |
|---|---|---|---|
| 1 | PARADA (espera de orden) |
— | E=1 → ESPERA_6S; F=1 → MUEVE_IZQ; G=1 → (R=1: GDER_ALEJA · R=0: GDER_ACERCA); H=1 → MUEVE_DER |
| 2 | ESPERA_6S |
— | T=1 → (R=1: GIZ_ALEJA · R=0: GIZ_ACERCA). E/F/G/H ignoradas |
| 3 | MUEVE_IZQ |
I | F=1 → quedarse; F=0 → PARADA |
| 4 | MUEVE_DER |
D | H=1 → quedarse; H=0 → PARADA |
| 5 | GIZ_ALEJA |
GIZQ | R=1 → quedarse (alejar la leva); R=0 → GIZ_ACERCA |
| 6 | GIZ_ACERCA |
GIZQ | R=0 → quedarse; R=1 → PARADA (vuelta completa / reposo alcanzado) |
| 7 | GDER_ALEJA |
GDER | R=1 → quedarse; R=0 → GDER_ACERCA |
| 8 | GDER_ACERCA |
GDER | R=0 → quedarse; R=1 → PARADA |
Claves del planteamiento (lo que puntúa):
- Solo
PARADAlee E/F/G/H. En cualquier otro estado los pulsadores no se miran: eso implementa literalmente "las activaciones de los pulsadores solo tendrán efecto si se realizan estando la vagoneta parada" (durante la cuenta de 6 s y durante el giro la máquina está ejecutando una maniobra: también se ignoran). - Vuelta completa en dos estados (ALEJA + ACERCA): si la rueda arranca en reposo (R=1), mantener un solo estado "hasta ver R=1" no giraría nada (R ya vale 1). Hay que salir de la ventana del sensor (esperar R=0) y volver a entrarla (R=1): eso es exactamente una vuelta. Si la rueda NO está en reposo, se entra directo en ACERCA y el giro termina al alcanzar el reposo.
- F y H son a nivel: el estado de desplazamiento dura mientras el pulson siga a 1 y sale inmediatamente al pasar a 0 ("se detendrá inmediatamente al cesar la pulsación").
- G no lleva cuenta de 6 s: el enunciado solo la menciona para E. Se decide sobre R
en el propio
PARADA. (Si en clase se explicó simetría con espera, se cambia G a ESPERA con giro a la derecha y se dice en una línea; lo que manda es el enunciado.) - El enunciado garantiza que el operador nunca pulsa dos botones a la vez: no hace falta priorizarlos entre sí.
📚 Teoría: Tema 3, pág. 15–19 del PDF «Tema 3 SD-II_20200413.pdf» — bloques de un diagrama ASM: cajas de estado (rectangulares, comportamiento Moore, incluyen las salidas de control), cajas de selección (rombo con dos salidas, deciden el estado siguiente), cajas de condición (esquinas redondeadas, Mealy) y bloque ASM: «todos los elementos existentes entre dos cajas de estado, incluyendo únicamente la primera», es decir todas sus operaciones se ejecutan en un mismo ciclo de reloj.
Ejemplo de recorrido: reposo con rueda en reposo →(E) ESPERA_6S[6 s] →(T,R=1) GIZ_ALEJA[GIZQ=1 hasta R=0] → GIZ_ACERCA[GIZQ=1 hasta R=1: una vuelta completa] → PARADA →(F mantenido) MUEVE_IZQ[I=1 mientras F=1] →(suelto F) PARADA.
b) Módulo VHDL del ASM (1,5 p)
Verificado con GHDL 4.1.0 (--std=08 -fsynopsys) sobre el bloque de arriba, analizado
literal: el testbench observa solo puertos y maneja R como la leva del sensor (nivel).
Con los generic reducidos PRE=9 y G_TICKS=150 (10 flancos por tick), la espera medida
es exactamente 1502 flancos = (PRE+1)·150 + 2, igual en la primera y en la segunda
espera (el contador se limpia al salir: sin restos), incluso tras un reset a mitad de la
cuenta. A escala real (PRE=999.999): 150.000.002 flancos, la cuenta exacta de
150.000.000 pulsos más 2 relojes (80 ns) de latencia de los registros. Comprobado
además: F pulsada durante ESPERA_6S no activa I (pulsación ignorada), el giro E
desconecta R al empezar y termina junto al reposo (ALEJA→ACERCA, una vuelta completa,
GIZQ sin cortes), G desde fuera de reposo gira a la derecha hasta alcanzarlo sin espera
de 6 s, G desde reposo da la vuelta completa por la derecha, F/H paran al cesar la
pulsación, durante reset=1 las cuatro salidas están en reposo, e I con D y GIZQ con
GDER nunca suben a la vez. El banco anterior (modelo físico de leva de 16 fases y
comprobación de linealidad en cuatro pre-escalas) no se ha re-ejecutado contra esta
estructura — registrado en las notas de elaboración.
📚 Teoría: Tema 3, pág. 23–24 del PDF «Tema 3 SD-II_20200413.pdf» — diagrama ASM
y módulo VHDL equivalente.
📚 Teoría: Tema 3, pág. 30–32 del PDF «Tema 3 SD-II_20200413.pdf» — traducción de
ASM a VHDL: «no es necesario llegar a una descripción como una estructura de
componentes»; se describe el comportamiento «como si fuera un diagrama de
estados», definiendo en cada estado las transiciones y transferencias, y
añadiendo reloj y reset a las señales de la tarjeta identificativa.
📚 Teoría: Tema 3, pág. 33–34 del PDF «Tema 3 SD-II_20200413.pdf» — simulación en
VHDL usando parametrización: para poder simular, «el valor de la cuenta máxima
del contador se ha reducido» (aquí son los generic G_PRE_MAX y G_TICKS).
library IEEE;
use IEEE.STD_LOGIC_1164.ALL;
use IEEE.STD_LOGIC_UNSIGNED.ALL;    -- aritmética de vectores, como en los apuntes

entity Vagoneta is
    generic (
        G_PRE_MAX : integer := 999_999;  -- pre-escala: cuenta 0..999.999 (MOD-1e6, 20 bits)
        G_TICKS   : integer := 150       -- ticks de 25 Hz: 150 x 40 ms = 6 s (MOD-150, 8 bits)
    );
    port (
        clk, reset   : in  std_logic;
        E, F, G, H   : in  std_logic;              -- pulsadores (nivel alto mientras se pulsan)
        R            : in  std_logic;              -- 1 = rueda izquierda en reposo
        I, D         : out std_logic;              -- traccion vagoneta: izquierda / derecha
        GIZQ, GDER   : out std_logic               -- giro de la rueda: izquierda / derecha
    );
end entity Vagoneta;

architecture ASM of Vagoneta is
    -- nombres de estado = nombres de los bloques del diagrama ASM
    type mis_estados is (PARADA, ESPERA_6S, MUEVE_IZQ, MUEVE_DER,
                         GIZ_ALEJA, GIZ_ACERCA, GDER_ALEJA, GDER_ACERCA);
    signal estado : mis_estados;

    -- temporizador de 6 s (modulo CTR del enunciado: solo corre en ESPERA_6S y se
    -- limpia al salir). Vector de 20 bits (999.999 < 1.048.575; la comparacion es por
    -- IGUALDAD, no suma+1: sin overflow)
    constant pre_bit : integer := 20;
    signal pre   : std_logic_vector(pre_bit-1 downto 0);  -- 25 MHz -> 25 Hz
    signal ticks : std_logic_vector(7 downto 0);          -- 150 x 40 ms = 6 s
    signal t     : std_logic;                             -- 6 s transcurridas
begin
    ------- proceso secuencial UNICO: contador del CTR + estado + salidas -------
    process
    begin
        wait until clk = '1';
        if reset = '1' then
            estado <= PARADA;
            I <= '0';  D <= '0';  GIZQ <= '0';  GDER <= '0';
            pre <= (others => '0');  ticks <= (others => '0');  t <= '0';
        else
            ------- el CTR de 6 s: habilitado solo en ESPERA_6S -------
            if estado /= ESPERA_6S then
                pre <= (others => '0');  ticks <= (others => '0');  t <= '0';
            elsif pre = G_PRE_MAX then
                pre <= (others => '0');
                if ticks = G_TICKS - 1 then t <= '1';
                else                        ticks <= ticks + 1;
                end if;
            else
                pre <= pre + 1;
            end if;
            ------- el ASM: salidas de traccion/giro dentro de cada estado -------
            case estado is
                when PARADA =>                        -- vagoneta parada: unico estado
                    I <= '0';  D <= '0';  GIZQ <= '0';  GDER <= '0';
                    if E = '1' then         estado <= ESPERA_6S;   -- donde mandan los botones
                    elsif F = '1' then      estado <= MUEVE_IZQ;
                    elsif G = '1' then
                        if R = '1' then     estado <= GDER_ALEJA;  -- en reposo: vuelta completa
                        else                estado <= GDER_ACERCA; -- fuera: hasta alcanzar reposo
                        end if;
                    elsif H = '1' then      estado <= MUEVE_DER;
                    end if;
                when ESPERA_6S =>                     -- E: cuenta de 6 s; botones ignorados
                    I <= '0';  D <= '0';  GIZQ <= '0';  GDER <= '0';
                    if t = '1' then
                        if R = '1' then     estado <= GIZ_ALEJA;
                        else                estado <= GIZ_ACERCA;
                        end if;
                    end if;
                when MUEVE_IZQ =>                     -- F a nivel: se para al cesar la pulsacion
                    I <= '1';  D <= '0';  GIZQ <= '0';  GDER <= '0';
                    if F = '0' then         estado <= PARADA;
                    end if;
                when MUEVE_DER =>                     -- H a nivel
                    I <= '0';  D <= '1';  GIZQ <= '0';  GDER <= '0';
                    if H = '0' then         estado <= PARADA;
                    end if;
                when GIZ_ALEJA =>                     -- rueda en reposo: primero ALEJARLA del sensor
                    I <= '0';  D <= '0';  GIZQ <= '1';  GDER <= '0';
                    if R = '0' then         estado <= GIZ_ACERCA;
                    end if;
                when GIZ_ACERCA =>                    -- ACERCARLA: termina al ver R de nuevo
                    I <= '0';  D <= '0';  GIZQ <= '1';  GDER <= '0';
                    if R = '1' then         estado <= PARADA;
                    end if;
                when GDER_ALEJA =>
                    I <= '0';  D <= '0';  GIZQ <= '0';  GDER <= '1';
                    if R = '0' then         estado <= GDER_ACERCA;
                    end if;
                when GDER_ACERCA =>
                    I <= '0';  D <= '0';  GIZQ <= '0';  GDER <= '1';
                    if R = '1' then         estado <= PARADA;
                    end if;
                when others =>
                    estado <= PARADA;
                    I <= '0';  D <= '0';  GIZQ <= '0';  GDER <= '0';
            end case;
        end if;
    end process;
end architecture ASM;
Notas para el examen: UN solo proceso secuencial con wait until clk='1' — dentro,
primero el contador del módulo CTR del enunciado (habilitado solo en ESPERA_6S,
limpio al salir) y después el case del ASM con las cuatro salidas de tracción/giro
escritas en todas las ramas (así ninguna se queda "memorizada" al cambiar de estado).
El contador en std_logic_vector con STD_LOGIC_UNSIGNED y comparación por igualdad
es lo de los apuntes; reset síncrono obligatorio (Tema 3, pág. 30–32). Los generic
son la parametrización de las págs. 33–34 para poder simular.
En el examen escribe las constantes directamente (if pre = 999_999, if ticks = 149).
El estado PARADA tras reset deja la máquina lista (la figura arranca con leva frente
al sensor).
Errores típicos — P1
- No escribir el cálculo de los 150.000.000 pulsos y su descomposición MOD-10⁶ × MOD-150: es parte del apartado a ("incluyendo los cálculos necesarios").
- Un solo estado de giro "hasta ver R=1" para el caso de vuelta completa: si la rueda arranca en reposo R ya vale 1 y el giro duraría 0 ciclos. La vuelta completa son dos estados (ALEJA espera R=0, ACERCA espera R=1). Justifícalo en dos líneas.
- Aceptar pulsadores fuera de
PARADA(p. ej. mirar F dentro de ESPERA_6S): el enunciado dice que solo tienen efecto con la vagoneta parada. Verificado en la simulación: F durante la cuenta no mueve la vagoneta. - Añadir la espera de 6 s a G: el enunciado solo la pide en E.
- Estados de desplazamiento que salen por un temporizador en vez de por F=0/H=0: el "mientras mantenga activado" es a nivel, se sale en cuanto cesa.
- Proceso combinacional sin valores por defecto (latches) o
caseincompleto. - Estados llamados E0, E1…: los nombres deben coincidir con los bloques del ASM.
- Olvidar que en GDER_ALEJA/GDER_ACERCA la salida es GDER (giro a la derecha), y que en el giro I y D deben estar a 0 (la vagoneta no se desplaza, solo gira la rueda).
Problema 2 — CPU von Neumann: microoperaciones y unidad de control (4 puntos)
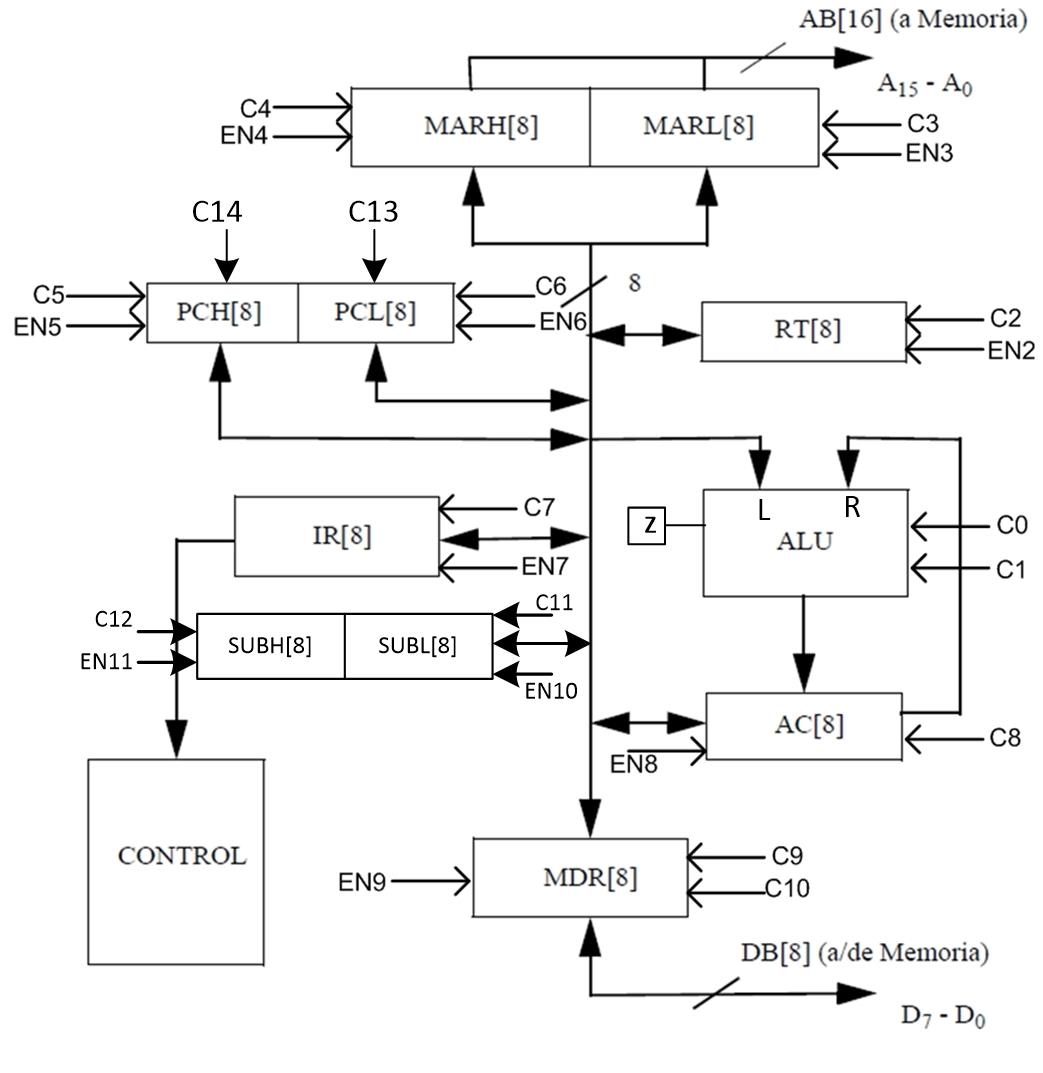
Planteamiento. La Unidad de Procesado transfiere datos por un bus interior
de 8 bits: la línea ENx de un registro lo conecta al bus (alta impedancia si
no está habilitada) y la línea Cx lo carga desde el bus (números exactos de la
figura: RT=EN2/C2, MARL=EN3/C3, MARH=EN4/C4, PCH=EN5/C5, PCL=EN6/C6, IR=EN7/C7,
AC=EN8/C8, MDR=EN9 con modo C10C9, SUBH=EN11/C12, SUBL=EN10/C11). El ciclo de
carga y decodificación es idéntico para todas las instrucciones (PC→MAR,
lectura de memoria→MDR, MDR→IR) y ocupa los 4 primeros micro-pasos; la ejecución
varía: las instrucciones de 2 bytes leen el dato en el paso siguiente y las de
dirección de 16 bits la montan byte a byte (primero la parte ALTA, luego la
BAJA, como fija el enunciado) usando RT como puente. La figura nativa (jpeg
incrustado en la pág. 2 del PDF) es idéntica, píxel a píxel, a la del examen
de junio-2024 (mismo jpeg 1043×1073), y muestra tres cableados que condonan
el plan: R de la ALU es una salida directa de RT (no hay registro R
cargable), la salida de la ALU solo escribe AC (no hay camino ALU→bus) y
MDR está visible con su modo C10C9 hacia el bus externo DB (D7–D0). Por eso
MUL3 (×3) se hace con RT←AC y dos sumas encadenadas con RT fijo en R, y ADD
fija el dato en RT. El microprograma completo son 55 microinstrucciones → MPC
de 6 bits, palabra de control de 24 bits.
📚 Teoría: Tema 5, págs. 4–6 del PDF — la microinstrucción se divide en campo de selección de condiciones, campo de direcciones de salto y campo de señales de control; y los componentes MPC, multiplexor de condiciones y memoria de control (ROM).
Baremo del enunciado: microoperaciones por instrucción + separación carga/decodificación vs ejecución: 3,25 p · diseño de la UC multiplexor–memoria–contador y conexión a la UO: 0,75 p.
Líneas de control dadas + supuestos (decláralos en el examen)
| C1 C0 | ALU | C14 C13 | PC | C10 C9 | MDR | ||
|---|---|---|---|---|---|---|---|
| 00 | L+R | 01 | incrementa PCH+PCL | 01 | carga del bus externo y entrada hacia el interior | ||
| 01 | L−R | 10 | resetea PCH+PCL | 10 | carga del bus interior y salida hacia el exterior | ||
| 10 | L | ||||||
| 11 | R+1 |
Supuestos (escríbelos): la figura no rotula cargas para L ni C: L es transparente (toma el valor del bus en el ciclo de operación ALU) y la salida de la ALU se captura en AC al activarse el código C1C0 (00/01/11); con C1C0=10 inactivo, AC se carga del bus con su C8. Existe un flag Z (caja Z en la figura) que vale 1 cuando el resultado de la última operación ALU es 0 (condición de JUMP Z). Escribir en la memoria externa requiere MDR configurado como salida (C10C9=10) más un pulso de escritura WE̅ de la CPU (el dibujo no lo rotula; decláralo). La pareja C11/C12·EN10/EN11 del par SUBH/SUBL se declara SUBH=C12/EN11, SUBL=C11/EN10. El bus interior admite una sola fuente ENx por micro-paso; la lectura/escritura externa (DB↔MDR) y el incremento del PC no usan el bus interior y sí pueden ir en paralelo con una transferencia interna. La dirección de 16 bits llega en dos bytes consecutivos: primero la ALTA, luego la BAJA (lo fija el enunciado).
Ciclo de carga y decodificación — común a TODAS las instrucciones (T0–T3)
| Paso | Micro-operación | Señales de control |
|---|---|---|
| T0 | MARH ← PCH | EN5, C4 |
| T1 | MARL ← PCL | EN6, C3 |
| T2 | MDR ← M[MAR] y en paralelo PC ← PC+1 | C10C9=01; C14C13=01 |
| T3 | IR ← MDR (decodificación; el opcode va además a CONTROL) | EN9, C7; MPC ← vector(IR) |
Tras T2 el PC apunta ya al byte siguiente. Contabilidad de incrementos: instrucción de 1 byte → PC suma 1 (T2); de 2 bytes → 2 (T2+E2); de 3 bytes → 3 (T2, E2 y E5). Todo lo que sigue de cada instrucción es ciclo de ejecución — y esa separación es exactamente lo que pide el enunciado (3,25 puntos).
Secuencias de ejecución por instrucción (EJECUCIÓN)
(1) LDAC $dir (00001000) — 3 bytes. AC ← M[$dir]. Ejecución (10 micro-op.):
| Paso | Micro-operación | Control |
|---|---|---|
| E0 | MARH ← PCH (PC apunta a la parte alta de $dir) | EN5, C4 |
| E1 | MARL ← PCL | EN6, C3 |
| E2 | MDR ← M[MAR] (byte ALTO de $dir); PC ← PC+1 | C10C9=01; C14C13=01 |
| E3 | RT ← MDR (guardo la parte alta) | EN9, C2 |
| E4 | MARL ← PCL (posición del byte BAJA; MARH sigue valiendo) | EN6, C3 |
| E5 | MDR ← M[MAR] (byte BAJA); PC ← PC+1 (ya apunta a la sig. instr.) | C10C9=01; C14C13=01 |
| E6 | MARH ← RT | EN2, C4 |
| E7 | MARL ← MDR → MAR = $dir completo | EN9, C3 |
| E8 | MDR ← M[MAR] (leo el dato; NO suma PC: los 3 incrementos van en T2, E2, E5) | C10C9=01 |
| E9 | AC ← MDR | EN9, C8 |
(2) ADD (dato) (00001001) — 2 bytes. AC ← AC + dato (actualiza Z).
Ejecución (5): E0 MARH←PCH (EN5,C4) · E1 MARL←PCL (EN6,C3) · E2 MDR←M[MAR] con
el dato, PC+1 · E3 RT ← MDR (EN9,C2: RT fija la entrada R directamente) ·
E4 AC ← L+R con C1C0=00 y EN8 en el bus (L = valor actual de AC; R = RT =
dato); Z ← (resultado=0).
(3) MUL3 (00001010) — 1 byte. AC ← 3×AC (actualiza Z). La ALU no
multiplica: ×3 = (AC+AC)+AC. RT guarda un operando fijo en R y L toma el valor
del bus en cada suma. Ejecución (3):
E0 RT ← AC (EN8,C2) · E1 AC ← L+R (C1C0=00; EN8 da L=A, R=RT=A) →
AC = 2A · E2 AC ← L+R (C1C0=00; EN8 da L=2A, R=RT=A) → AC = 3A; Z←(=0).
⚠ Con esta figura no existe RT ← salida ALU (la ALU solo escribe AC) ni
registro R cargable: el borrador clásico «L←AC, R←AC, RT←C, R←RT» es
imposible. Una sola suma con L=R=AC daría 2×AC, no 3×AC. C1C0=11 (R+1) no
sirve para multiplicar. PC ya está completo tras T2 (1 byte).
(4) SUBR $dir (00001011) — 3 bytes. SUB ← PC (retorno); PC ← $dir.
Ejecución (10): E0–E2 como LDAC (MAR←PC, lee byte ALTO, PC+1) · E3 RT←MDR ·
E4 MARL←PCL · E5 MDR←M[MAR] (byte BAJA); PC←PC+1 → PC = instrucción
siguiente (retorno) · E6 SUBH←PCH (EN5,C12) · E7 SUBL←PCL (EN6,C11) →
SUB = dirección de retorno · E8 PCH←RT (EN2,C5) · E9 PCL←MDR (EN9,C6) →
PC = $dir.
(5) RETS (00001100) — 1 byte. PC ← SUB. Ejecución (2):
E0 PCH←SUBH (EN11,C5) · E1 PCL←SUBL (EN10,C6). El +1 del fetch sobre el opcode
de RETS queda destruido por la carga: correcto.
(6) JUMP Z $dir (00001101) — 3 bytes. Salta a $dir si la última operación ALU dio 0. No se toca la ALU en la ejecución para no destruir Z. Ejecución (10): E0–E5 idénticos al montaje LDAC (RT=alta, MDR=baja, PC+1 en E2 y E5 → PC = opcode+3, efecto «no salto») · E6 decisión sobre Z (micro-paso sin señales; en la UC: MPC ← A+Z): Z=0 → paso nulo E7' → fetch siguiente; Z=1 → E7 PCH←RT (EN2,C5) · E8 PCL←MDR (EN9,C6) → PC = $dir.
(7) STAC $dir (00001110) — 3 bytes. M[$dir] ← AC. Ejecución (10):
E0–E7 como LDAC hasta MAR = $dir · E8 MDR ← AC con C10C9=10 y EN8 (bus
interior → MDR, configurado como salida al exterior) · E9 M[MAR]←MDR (pulso
WE̅ a la memoria).
(8) STOP (00001111) — 1 byte. Tras el fetch (T0–T3) el microprograma entra en un bucle sin señales (MPC auto-saltándose): unidad operativa inactiva hasta reset. No genera ningún incremento (el +1 de T2 del fetch es común a todo fetch y queda inutilizado).
Verificación: estas 8 secuencias se codificaron como el microprograma de la
tabla del apartado de la UC (micro 00H–36H) y se ejecutaron en un modelo Python
de la unidad de procesado (con la regla de un solo driver ENx por ciclo, MAR
completo antes de cada acceso a memoria e IR cargado siempre desde MDR) con el
programa LDAC $2000 (dato 07H) · ADD 5 · MUL3 · SUBR $3000 (ADD 1; RETS) ·
STAC $0040 · JUMP Z $5000 · STOP: AC = 07H → 0CH → 24H → (subr) 25H,
SUB = 0009H, tras RETS PC = 0009H, M[0040H] = 25H, JUMP Z no tomado (el
último ALU, ADD 1, dejó Z=0), PC final 0010H. Segundo test con ADD FB
(AC=05+FB=00 → Z=1) y subrutina vacía: MUL3(0)=0 mantiene Z=1 y JUMP Z
tomado → PC = 5000H y STOP en 5000H deja PC final 5001H. Todos los PC
intermedios exactos.
Unidad de control: multiplexor – memoria de control – contador, y conexión a la UO (0,75 p)
📚 Teoría: Tema 5, pág. 9 del PDF — «Diseño de la unidad de control (I)»: el tamaño de la memoria de control lo condiciona el tamaño del microprograma y la palabra debe contener el campo de selección de condiciones, el de direcciones de salto y el de señales de control.
Componentes y conexión (dibujar):
              ┌────────────────────────────────────────────────────┐
              │  MUX 5:1 de siguiente dirección (campo SEL)        │
              │   000: MPC+1        011: vector(IR) ← mini-ROM     │
              │   001: A+Z (salto   010: A (salto abs./STOP)       │
              │         condicional) 100: 000000 (fin: fetch)      │
              └───────────────┬────────────────────────────────────┘
                              ▼ carga paralela / cuenta
  reset ──► MPC (contador 6 bits) ──► MC (ROM/PLA 64 palabras × 24 bits) ──► CMBR
  CMBR: campos SRC/DEST ──► descodificador SRC→ENx; descodificador DEST→Cx;
        C1C0→ALU; C10C9→MDR; C14C13→PC; WE→pulso WE̅ a la memoria externa
  CMBR: SEL y A ──► MUX anterior;  IR(3:0) ──► mini-ROM vector (opcode→dirección);
  Z (flag ALU) ──► suma A+Z;  reset ──► MPC←0
- MPC: contador de 6 bits (55 microinstrucciones ≤ 64) con carga paralela y reset.
- MC: memoria de control, 64 palabras de 24 bits direccionadas por MPC (ROM o PLA).
- CMBR: registro buffer de la microinstrucción (24 bits) que paraleliza los campos.
- Conexión con la unidad operativa: el campo SRC pasa por un descodificador que genera las líneas ENx (una sola activa por ciclo); el campo DEST genera las señales de carga Cx; C1C0/C10C9/C14C13/WE van directas a ALU, MDR, PC y memoria (con C1C0 activo, la captura ALU→AC sustituye la carga C8). Entradas externas de la UC: IR(3:0) → mini-ROM vector (la línea IR→CONTROL está en la figura), y Z → suma A+Z del salto condicional.
Mapa del microprograma (55 microinstrucciones, direcciones MC):
| Instrucción | opcode | Dirección MC | Micro-op. ejecución |
|---|---|---|---|
| Fetch (T0–T3) | — | 00H–03H | — (común) |
| LDAC | 08H | 04H–0DH | 10 |
| ADD | 09H | 0EH–12H | 5 |
| MUL3 | 0AH | 13H–15H | 3 |
| SUBR | 0BH | 16H–1FH | 10 |
| RETS | 0CH | 20H–21H | 2 |
| JUMP Z | 0DH | 22H–2BH | 8 + decisión + paso nulo |
| STAC | 0EH | 2CH–35H | 10 |
| STOP | 0FH | 36H (bucle SEL=010, A=36H) | 0 |
Vector código→dirección (mini-ROM 16×6 indexada por IR(3:0), usada en SEL=011
de la micro 03H): 08H→04H, 09H→0EH, 0AH→13H, 0BH→16H, 0CH→20H, 0DH→22H,
0EH→2CH, 0FH→36H (códigos 00H–07H no definidos: pueden dirigir a 36H como si
fueran STOP).
Tabla completa de microinstrucciones (cada fila es un ciclo del modelo
ejecutado; -- = campo inactivo; la columna EN es la fuente al bus interior y
la columna C la carga desde el bus):
| MC | EN (origen) | C (destino) | C1C0 | C10C9 | C14C13 | WE | SEL | A | Acción |
|---|---|---|---|---|---|---|---|---|---|
| 00H | EN5 PCH | C4 MARH | -- | -- | -- | 0 | 000 | -- | MARH←PCH |
| 01H | EN6 PCL | C3 MARL | -- | -- | -- | 0 | 000 | -- | MARL←PCL |
| 02H | -- | -- | -- | 01 | 01 | 0 | 000 | -- | MDR←M[MAR]; PC+1 |
| 03H | EN9 MDR | C7 IR | -- | -- | -- | 0 | 011 | -- | IR←MDR; MPC←vector(IR) |
| 04H | EN5 PCH | C4 MARH | -- | -- | -- | 0 | 000 | -- | LDAC: MARH←PCH |
| 05H | EN6 PCL | C3 MARL | -- | -- | -- | 0 | 000 | -- | MARL←PCL |
| 06H | -- | -- | -- | 01 | 01 | 0 | 000 | -- | lee byte alto $dir; PC+1 |
| 07H | EN9 MDR | C2 RT | -- | -- | -- | 0 | 000 | -- | RT←alta($dir) |
| 08H | EN6 PCL | C3 MARL | -- | -- | -- | 0 | 000 | -- | MARL←PCL |
| 09H | -- | -- | -- | 01 | 01 | 0 | 000 | -- | lee byte bajo; PC+1 |
| 0AH | EN2 RT | C4 MARH | -- | -- | -- | 0 | 000 | -- | MARH←alta |
| 0BH | EN9 MDR | C3 MARL | -- | -- | -- | 0 | 000 | -- | MARL←bajo → MAR=$dir |
| 0CH | -- | -- | -- | 01 | -- | 0 | 000 | -- | MDR←M[$dir] (sin PC+1) |
| 0DH | EN9 MDR | C8 AC | -- | -- | -- | 0 | 100 | -- | AC←MDR; fetch siguiente |
| 0EH | EN5 PCH | C4 MARH | -- | -- | -- | 0 | 000 | -- | ADD: MARH←PCH |
| 0FH | EN6 PCL | C3 MARL | -- | -- | -- | 0 | 000 | -- | MARL←PCL |
| 10H | -- | -- | -- | 01 | 01 | 0 | 000 | -- | MDR←dato; PC+1 |
| 11H | EN9 MDR | C2 RT | -- | -- | -- | 0 | 000 | -- | RT←dato (R=RT directo) |
| 12H | EN8 AC | -- | 00 | -- | -- | 0 | 100 | -- | AC←L+R; Z; fetch |
| 13H | EN8 AC | C2 RT | -- | -- | -- | 0 | 000 | -- | MUL3: RT←AC |
| 14H | EN8 AC | -- | 00 | -- | -- | 0 | 000 | -- | AC←AC+RT=2AC (R=RT fijo) |
| 15H | EN8 AC | -- | 00 | -- | -- | 0 | 100 | -- | AC←AC+RT=3AC; Z; fetch |
| 16H | EN5 PCH | C4 MARH | -- | -- | -- | 0 | 000 | -- | SUBR: MARH←PCH |
| 17H | EN6 PCL | C3 MARL | -- | -- | -- | 0 | 000 | -- | MARL←PCL |
| 18H | -- | -- | -- | 01 | 01 | 0 | 000 | -- | lee byte alto; PC+1 |
| 19H | EN9 MDR | C2 RT | -- | -- | -- | 0 | 000 | -- | RT←alta($dir) |
| 1AH | EN6 PCL | C3 MARL | -- | -- | -- | 0 | 000 | -- | MARL←PCL |
| 1BH | -- | -- | -- | 01 | 01 | 0 | 000 | -- | lee byte bajo; PC+1 (=retorno) |
| 1CH | EN5 PCH | C12 SUBH | -- | -- | -- | 0 | 000 | -- | SUBH←PCH |
| 1DH | EN6 PCL | C11 SUBL | -- | -- | -- | 0 | 000 | -- | SUBL←PCL → SUB=retorno |
| 1EH | EN2 RT | C5 PCH | -- | -- | -- | 0 | 000 | -- | PCH←alta($dir) |
| 1FH | EN9 MDR | C6 PCL | -- | -- | -- | 0 | 100 | -- | PCL←bajo → PC=$dir; fetch |
| 20H | EN11 SUBH | C5 PCH | -- | -- | -- | 0 | 000 | -- | RETS: PCH←SUBH |
| 21H | EN10 SUBL | C6 PCL | -- | -- | -- | 0 | 100 | -- | PCL←SUBL; fetch |
| 22H | EN5 PCH | C4 MARH | -- | -- | -- | 0 | 000 | -- | JZ: MARH←PCH |
| 23H | EN6 PCL | C3 MARL | -- | -- | -- | 0 | 000 | -- | MARL←PCL |
| 24H | -- | -- | -- | 01 | 01 | 0 | 000 | -- | lee byte alto; PC+1 |
| 25H | EN9 MDR | C2 RT | -- | -- | -- | 0 | 000 | -- | RT←alta($dir) |
| 26H | EN6 PCL | C3 MARL | -- | -- | -- | 0 | 000 | -- | MARL←PCL |
| 27H | -- | -- | -- | 01 | 01 | 0 | 000 | -- | lee byte bajo; PC+1 (no salta) |
| 28H | -- | -- | -- | -- | -- | 0 | 001 | 29H | MPC←29H+Z: Z=0→29H · Z=1→2AH |
| 29H | -- | -- | -- | -- | -- | 0 | 100 | -- | Z=0: paso nulo → fetch siguiente |
| 2AH | EN2 RT | C5 PCH | -- | -- | -- | 0 | 000 | -- | Z=1: PCH←alta($dir) |
| 2BH | EN9 MDR | C6 PCL | -- | -- | -- | 0 | 100 | -- | PCL←bajo → PC=$dir; fetch |
| 2CH | EN5 PCH | C4 MARH | -- | -- | -- | 0 | 000 | -- | STAC: MARH←PCH |
| 2DH | EN6 PCL | C3 MARL | -- | -- | -- | 0 | 000 | -- | MARL←PCL |
| 2EH | -- | -- | -- | 01 | 01 | 0 | 000 | -- | lee byte alto; PC+1 |
| 2FH | EN9 MDR | C2 RT | -- | -- | -- | 0 | 000 | -- | RT←alta($dir) |
| 30H | EN6 PCL | C3 MARL | -- | -- | -- | 0 | 000 | -- | MARL←PCL |
| 31H | -- | -- | -- | 01 | 01 | 0 | 000 | -- | lee byte bajo; PC+1 |
| 32H | EN2 RT | C4 MARH | -- | -- | -- | 0 | 000 | -- | MARH←alta |
| 33H | EN9 MDR | C3 MARL | -- | -- | -- | 0 | 000 | -- | MARL←bajo → MAR=$dir |
| 34H | EN8 AC | -- | -- | 10 | -- | 0 | 000 | -- | MDR←AC (bus interior, salida exterior) |
| 35H | -- | -- | -- | -- | -- | 1 | 100 | -- | M[MAR]←MDR (WE̅); fetch |
| 36H | -- | -- | -- | -- | -- | 0 | 010 | 36H | STOP: bucle sin señales |
Justificación de anchuras: 55 microinstrucciones ≤ 64 → MPC y campo A de 6
bits; palabra de control (CMBR) de 24 bits en el orden
SRC(4) DEST(4) C1C0(2) C10C9(2) C14C13(2) WE(1) SEL(3) A(6)
= 4+4+2+2+2+1+3+6 = 24. Codificación de los campos:
| Campo | Bits | Codificación |
|---|---|---|
| SRC | 4 | 0000=bus flotante · 0001=AC (EN8) · 0010=MDR (EN9) · 0011=RT (EN2) · 0100=PCH (EN5) · 0101=PCL (EN6) · 0110=SUBH (EN11) · 0111=SUBL (EN10) |
| DEST | 4 | 0000=ninguna · 0001=AC (C8) · 0010=IR (C7) · 0011=RT (C2) · 0100=PCH (C5) · 0101=PCL (C6) · 0110=MARH (C4) · 0111=MARL (C3) · 1000=SUBH (C12) · 1001=SUBL (C11) |
| C1C0 | 2 | operación ALU; en filas que no la usan se pone 10 (= pasa L), inocuo porque la captura ALU→AC solo ocurre con códigos de operación (00/01/11) |
| C10C9 | 2 | 00 inactivo · 01 lectura externa→MDR · 10 bus interior→MDR hacia memoria |
| C14C13 | 2 | 00 nada · 01 incrementa PC · 10 reset PC |
| WE | 1 | pulso de escritura WE̅ a memoria externa |
| SEL | 3 | 000 MPC+1 · 001 MPC←A+Z · 010 MPC←A · 011 MPC←vector(IR) · 100 MPC←000000 (fetch) |
| A | 6 | dirección de salto (0 si SEL=000/011/100) |
El problema no pide codificación binaria de palabras de control: con la tabla de campos y el mapa anterior queda diseñado el formato. (📚 Tema 5, págs. 17–18: el microprograma simbólico del procesador de ejemplo arranca con el mismo fetch que aquí — MAR←PC, IR←M(MAR), PC←PC+1 — y las microórdenes del mapa anterior son directamente codificables en ese formato.)
Errores típicos — P2
- No separar claramente el ciclo de carga/decodificación (T0–T3 comunes) del de ejecución: es literalmente lo que pide el enunciado (3,25 p por el desglose).
- Olvidar que la dirección de 16 bits llega en dos bytes (alta primero) y montar MAR en un solo paso: hacen falta 2 lecturas + RT de puente.
- MUL3 en una sola suma: AC+AC = 2×AC, no 3×AC. Con esta ALU, ×3 = RT←AC y después dos sumas encadenadas (AC←L+R con R=RT fijo, dos veces). Y como la ALU solo escribe AC, el plan «RT ← salida de la ALU» o usar registros L/R cargables es imposible: no existen en la figura.
- Usar señales ficticias (algo como «LDMARH» o «ENPCH» genéricas): la figura da números concretos EN2–EN11 y C2–C14 y hay que usarlos tal cual.
- PC+1 de más: en instrucciones de 2 bytes el PC ya sumó en T2 y E2; en las de 3 bytes el tercer incremento va en la lectura del byte bajo (E5), no al final. Verificado en el modelo: con un +1 de más el programa se descuadra tras la primera instrucción.
- En SUBR guardar SUB antes del último PC+1: SUB quedaría apuntando al byte bajo del operando en vez de a la instrucción siguiente.
- En JUMP Z usar la ALU antes de la decisión y destruir Z; o decidir con el acarreo por el aspecto del mnemonic: la descripción funcional manda (Z).
- Decidir JUMP Z "en el aire": hay que materializarlo con el salto condicional de la UC (SEL=001, MPC←A+Z) y reservar un paso nulo para el camino "no salta".
- Escribir "MDR←AC" a secas en STAC: hace falta C10C9=10 (salida al exterior) y el pulso de escritura en un paso distinto.
- Dejar el MPC sin bits suficientes: 55 microinstrucciones → 6 bits; justifica también el campo A (6 bits) y la MC de 64×24.
- No conectar la mini-ROM vector (opcode→dirección) ni la línea Z al MUX de la UC: sin ellas no hay decodificación por salto ni bifurcación.
Problema 3 — Mapa de memoria de 64K posiciones (2 puntos)
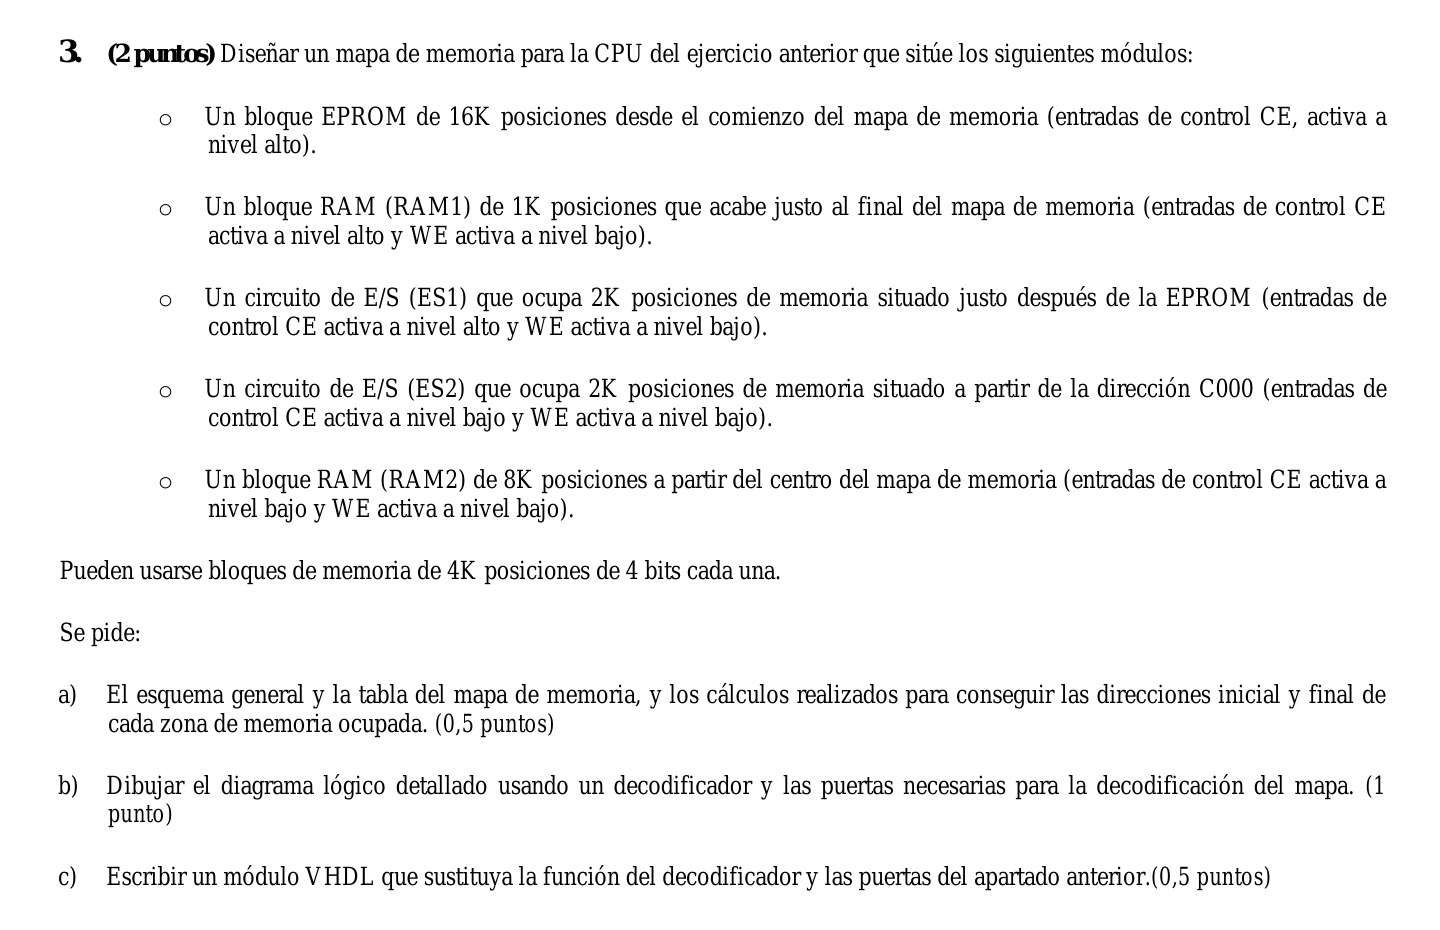
Planteamiento. La CPU del problema 2 tiene bus de datos de 8 bits y direcciones de 16 bits → 64K posiciones (2¹⁶ = 10000H), mapa 0000H–FFFFH, líneas A15–A0. Se colocan EPROM de 16K al principio, ES1 de 2K a continuación, RAM2 de 8K en el centro (8000H), ES2 de 2K en C000H y RAM1 de 1K anclada al final; no hay solapes. Con CIs de 4K×4 hay expansión de palabras y de bits en la EPROM y en RAM2, y la decodificación se hace con las 6 líneas altas A15–A10 respetando la polaridad CE/WE de cada bloque (EPROM, RAM1 y ES1 con CE ALTO; ES2 y RAM2 con CE BAJO).
Datos que fija el enunciado y decisiones de diseño. Fija el enunciado: que el mapa sea "para la CPU del ejercicio anterior" —el problema 2 fija bus de direcciones A15–A0 y bus de datos D7–D0→ 64K posiciones de 8 bits; los cinco módulos con su tamaño y su anclaje: EPROM 16K desde el comienzo del mapa, ES1 2K justo después de la EPROM, RAM2 8K a partir del centro del mapa, ES2 2K a partir de la dirección C000 y RAM1 1K que acaba justo al final; las polaridades de control (EPROM: CE ALTO, el enunciado no le menciona WE porque es ROM; ES1 y RAM1: CE ALTO y WE BAJO; ES2 y RAM2: CE BAJO y WE BAJO); que "pueden usarse" CIs de memoria de 4K posiciones de 4 bits cada una; y el baremo: a) esquema general + tabla del mapa + cálculos: 0,5 p · b) diagrama lógico con decodificador y puertas: 1 p · c) módulo VHDL del decodificador: 0,5 p. El examen escribe la dirección de inicio de ES2 como "C000" sin sufijo H: en esta guía se usa la notación C000H, como en el resto del mapa. No lo fija el enunciado: el decodificador concreto (solo pide "un decodificador y las puertas necesarias"). La guía usa un decodificador 3–8 habilitado con entradas A15,A14,A13 y salidas Y0–Y7 activas ALTO, más puertas AND/OR: es decisión propia igualmente válida que usar solo puertas con las 6 líneas altas A15–A10 (se desarrollan las dos versiones en el apartado b) o un circuito programable como el VHDL del apartado c). El examen enumera los módulos en orden EPROM, RAM1, ES1, ES2, RAM2; la guía los ordena por posición en el mapa (EPROM, ES1, RAM2, ES2, RAM1), que es como se usan en los cálculos.
Datos de partida y cálculos de cabida
- 64K posiciones = 2¹⁶ = 10000H posiciones → mapa 0000H–FFFFH (A15–A0).
- Tamaños en hex: 16K = 4000H; 8K = 2000H; 2K = 800H; 1K = 400H.
- EPROM desde el comienzo: 0000H → 0000H+4000H−1 = 0000H–3FFFH.
- ES1 "justo después": 4000H–47FFH (4000H+800H−1).
- RAM2 en el centro del mapa: 10000H/2 = 8000H → 8000H–9FFFH (+2000H−1).
- ES2 desde C000H: C000H–C7FFH.
- RAM1 "acaba al final": inicio = FFFFH − 400H + 1 = FC00H–FFFFH. ⚠ El error fácil es poner F400H (eso serían 3K: FFFFH−F400H+1 = C00H). Compruébalo siempre: tamaño = final − inicio + 1.
- Suma usada: 16K+2K+8K+2K+1K = 29K ≤ 64K ✔. Sin solapes (comprobado barriendo las 65.536 direcciones del mapa): quedan libres 4800H–7FFFH (14K), A000H–BFFFH (8K) y C800H–FBFFH (13K); total libre 35K; 29K+35K = 64K ✔.
📚 Teoría: Tema 5, pág. 32 del PDF «Tema 5 SD-II_20230215.pdf» — capacidad direccionable y concepto de mapa. 📚 Teoría: Tema 1, pág. 53 del PDF «Tema 1 SD-II_20200206.pdf» — memoria organizada en palabras de m bits.
a) Esquema general, tabla del mapa y cálculos (0,5 p)
| Módulo | Tamaño | Inicial | Final | CE | WE | Direcciones internas |
|---|---|---|---|---|---|---|
| EPROM | 16K | 0000H | 3FFFH | ALTO | — (ROM) | A13–A0 |
| ES1 | 2K | 4000H | 47FFH | ALTO | BAJO | A10–A0 |
| Hueco | 14K | 4800H | 7FFFH | — | — | — |
| RAM2 | 8K | 8000H | 9FFFH | BAJO | BAJO | A12–A0 |
| Hueco | 8K | A000H | BFFFH | — | — | — |
| ES2 | 2K | C000H | C7FFH | BAJO | BAJO | A10–A0 |
| Hueco | 13K | C800H | FBFFH | — | — | — |
| RAM1 | 1K | FC00H | FFFFH | ALTO | BAJO | A9–A0 |
Nº de CIs por bloque (el enunciado permite bloques de 4K posiciones × 4 bits):
| Bloque | CI disponible | Palabras | Bits | Nº CI |
|---|---|---|---|---|
| EPROM 16K×8 | 4K×4 | 16K/4K = 4 filas | 8/4 = 2 en paralelo | 8 |
| RAM2 8K×8 | 4K×4 | 8K/4K = 2 filas | 8/4 = 2 en paralelo | 4 |
| RAM1 1K×8 | 4K×4 (solo hace falta 1K) | 1 fila | 8/4 = 2 en paralelo | 2 (los CI de 4K solo se decodifican para 1K: A11–A10 de la CI fijados a 0; el rango seleccionado es FC00H–FFFFH exactamente) |
| ES1, ES2 | módulos E/S hechos (2K×8) | — | — | 1 + 1 |
Total: 14 CIs de memoria (8+4+2) más 2 módulos E/S. En cada fila, un CI lleva los bits D3–D0 y su gemelo en paralelo D7–D4 (comparten direcciones y CE; la otra mitad de los 4 bits queda cubierta).
Esquema general del mapa (el apartado a) pide esquema + tabla; la tabla va arriba y el esquema, debajo):
Figura: esquema del mapa de 64K posiciones en orden, con tamaños, rangos y polaridades CE/WE.
📚 Teoría: Tema 5, pág. 33 del PDF «Tema 5 SD-II_20230215.pdf» — ejemplo de mapa: ROM al final, RAM al principio. 📚 Teoría: Tema 1, pág. 54 del PDF «Tema 1 SD-II_20200206.pdf» — tipos de ROM: programables, PROM y EPROM.
b) Decodificación y diagrama lógico (1 p)
El bloque más pequeño mide 1K → hay que decodificar con las 6 líneas altas A15–A10. Estructura práctica: un decodificador 3–8 habilitado conectado a A15,A14,A13 (salidas Y0–Y7 activas ALTO, cada una = un sector de 8K) más puertas:
| Y | Sector | Uso |
|---|---|---|
| Y0, Y1 | 0000H–3FFFH | EPROM: CE(EPROM) = Y0 + Y1 (16K justas; cada una habilita 2 de las 4 filas según A13 — ver ecuaciones de abajo) |
| Y2 | 4000H–5FFFH | ES1 (1ª mitad): CE(ES1) = Y2 · A̅12 · A̅11 |
| Y4 | 8000H–9FFFH | RAM2 exacto: CE̅(RAM2) = Y̅4 (sector de 8K justas) |
| Y6 | C000H–DFFFH | ES2 (1ª mitad): CE̅(ES2) = Y̅6 + A12 + A11 (OR: activo BAJO) |
| Y7 | E000H–FFFFH | RAM1 (última 1K): CE(RAM1) = Y7 · A12 · A11 · A10 |
(En un Y con salida ALTO, una señal activa BAJO se consigue negando el producto:
CE̅(ES2) = NOT(Y6·A̅12·A̅11) = Y̅6 + A12 + A11.)
Ecuaciones equivalentes directamente en las 6 líneas altas (válidas y más compactas si no se dibuja el 3–8):
CE(EPROM)(ALTO) = A̅15·A̅14 → 0000H–3FFFH.- Filas internas de EPROM (4K, con CE ALTO y A11–A0 internos): con A13,A12:
CE_E0 = A̅15·A̅14·A̅13·A̅12(0000H–0FFFH),CE_E1 = A̅15·A̅14·A̅13·A12(1000H–1FFFH),CE_E2 = A̅15·A̅14·A13·A̅12(2000H–2FFFH),CE_E3 = A̅15·A̅14·A13·A12(3000H–3FFFH). CE(ES1)(ALTO) = A̅15·A14·A̅13·A̅12·A̅11 → 4000H–47FFH (A10 libre: es interna del módulo).CE̅(RAM2)(BAJO) = A15·A̅14·A̅13 → 8000H–9FFFH. Filas por A12:CS_R0̅ = NOT(A15·A̅14·A̅13·A̅12)(8000H–8FFFH),CS_R1̅ = NOT(A15·A̅14·A̅13·A12)(9000H–9FFFH).CE̅(ES2)(BAJO) = A15·A14·A̅13·A̅12·A̅11 → C000H–C7FFH.CE(RAM1)(ALTO) = A15·A14·A13·A12·A11·A10 → FC00H–FFFFH (comparte CE ambos CI del par).- En los huecos ninguna señal se activa: no hay que decodificarlos.
Diagrama lógico (descripción para dibujar): CPU con A15–A0, D7–D0 y WE̅. La EPROM: 8 CI 4K×4 en 4 filas de 2 (gemelos comparten CE y direcciones); A11–A0 a todas; CE de cada fila con la ecuación CE_E0..E3. ES1: módulo 2K×8, A10–A0, CE = ecuación, WE̅ de la CPU. RAM2: 4 CI 4K×4 en 2 filas de 2, A11–A0, CS̅ = ecuaciones CS_R0̅/CS_R1̅, WE̅ común. ES2: módulo 2K×8, A10–A0, CE̅ y WE̅. RAM1: 2 CI en paralelo, A9–A0, CE = ecuación (ALTO), WE̅. WE̅ de la CPU va a RAM1, RAM2, ES1 y ES2 (la EPROM no lleva WE). Las ecuaciones se montan con el decodificador 3–8 (A15,A14,A13 a las entradas de selección; entrada de habilitación fija activa) más las puertas AND/OR indicadas.
El diagrama lógico montado (es la descripción anterior dibujada: decodificador 3–8, puertas para cada CS y los CIs 4K×4 en paralelo por filas):
Figura: diagrama lógico del mapa — decodificador 3–8 + puertas AND/NAND, EPROM (4 filas × 2 CI), RAM2 (2 filas × 2 CI), RAM1 (2 CI sobredimensionadas) y los módulos ES1/ES2, con buses A15–A0, D7–D0 y WE̅.
📚 Teoría: Tema 5, pág. 34–35 del PDF «Tema 5 SD-II_20230215.pdf» — condiciones de habilitación según líneas altas. 📚 Teoría: Tema 1, pág. 3–5 del PDF «Tema 1 SD-II_20200206.pdf» — decodificador completo: n entradas y 2ⁿ salidas. 📚 Teoría: Tema 5, pág. 40 del PDF «Tema 5 SD-II_20230215.pdf» — opciones de decodificación: decodificador, puertas o VHDL.
c) Módulo VHDL del decodificador (0,5 p)
Analizado con GHDL y simulado con un banco de 64 muestras representativas (una por
cada bloque de 1024 direcciones — como el módulo solo recibe A15–A10, esas 64 muestras
agotan su espacio de entrada), y comprobado además barriendo las 65.536
direcciones del mapa con las ecuaciones equivalentes del apartado b): cada señal
activa exactamente en su rango, cero solapes, huecos sin activar (0 fallos). El bloque
es decodificación directa por compuertas — estilo del enunciado, intacto en el pase de
estilo — y el barrido se ha vuelto a ejecutar contra él en GHDL --std=08 -fsynopsys
(12/11): mismas cuentas exactas y 0 solapes.
library IEEE;
use IEEE.STD_LOGIC_1164.ALL;

entity Decodificador_Map is
    port (
        A       : in  std_logic_vector(15 downto 10);  -- 6 lineas altas
        CE_EP   : out std_logic_vector(3 downto 0);    -- 4 filas EPROM 4Kx8, CE ALTO
        CE_ES1  : out std_logic;                       -- ES1 4000H-47FFH, CE ALTO
        CS_RAM2 : out std_logic_vector(1 downto 0);    -- 2 filas RAM2 4Kx8, CS BAJO
        CS_ES2  : out std_logic;                       -- ES2 C000H-C7FFH, CS BAJO
        CE_RAM1 : out std_logic                        -- RAM1 FC00H-FFFFH, CE ALTO
    );
end entity Decodificador_Map;

architecture Behaviour of Decodificador_Map is
begin
    -- EPROM 0000H-3FFFH: filas de 4K elegidas con A13,A12 (sector A15A14=00)
    CE_EP(0) <= not A(15) and not A(14) and not A(13) and not A(12);  -- 0000H-0FFFH
    CE_EP(1) <= not A(15) and not A(14) and not A(13) and     A(12);  -- 1000H-1FFFH
    CE_EP(2) <= not A(15) and not A(14) and     A(13) and not A(12);  -- 2000H-2FFFH
    CE_EP(3) <= not A(15) and not A(14) and     A(13) and     A(12);  -- 3000H-3FFFH
    -- ES1 4000H-47FFH (2K)
    CE_ES1  <= not A(15) and     A(14) and not A(13) and not A(12) and not A(11);
    -- RAM2 8000H-9FFFH (8K): sector A15=1 A14=0 A13=0; filas por A12. Activa BAJO
    CS_RAM2(0) <= not (    A(15) and not A(14) and not A(13) and not A(12)); -- 8000H-8FFFH
    CS_RAM2(1) <= not (    A(15) and not A(14) and not A(13) and     A(12)); -- 9000H-9FFFH
    -- ES2 C000H-C7FFH (2K). Activa BAJO
    CS_ES2  <= not (    A(15) and     A(14) and not A(13) and not A(12) and not A(11));
    -- RAM1 FC00H-FFFFH (1K): A15..A10 = 1
    CE_RAM1 <=     A(15) and     A(14) and     A(13) and     A(12) and A(11) and A(10);
end architecture Behaviour;
📚 Teoría: Tema 5, pág. 36–37 del PDF «Tema 5 SD-II_20230215.pdf» — VHDL de la decodificación del mapa (dos versiones). 📚 Teoría: Tema 1, pág. 33–34 del PDF «Tema 1 SD-II_20200206.pdf» — decodificador 3–8 en VHDL, con línea de enable.
Errores típicos — P3
- Calcular mal el inicio de RAM1: acabar en FFFFH con 1K (400H) significa empezar en FC00H, no en F400H (F400H–FFFFH son 3K). Comprueba tamaño = final−inicio+1 en cada fila de la tabla.
- Confundir polaridades: ES2 y RAM2 tienen CE BAJO (su ecuación es la OR negada /
producto negado), EPROM, ES1 y RAM1 CE ALTO (producto directo). Un
notde más invierte el mapa: el barrido simulado lo detecta al instante. - OLVIDAR la expansión de bits: el bus de datos es de 8 y la CI de 4 bits → 2 CI en paralelo siempre (8 CIs en la EPROM y 4 en RAM2, no 4 y 2). Es lo primero que se comprueba.
- Creer que la RAM1 necesita 4K de mapa: el mapa le da 1K; se decodifica exactamente FC00H–FFFFH (las A11–A10 de la CI se fijan a 0, o equivalentemente solo se habilita ese rango). Justifícalo en una línea.
- Usar menos de 6 líneas altas: el bloque más pequeño es de 1K → A15–A10; con solo A15–A14 el RAM1 solaparía el hueco C800H–FBFFH y la selección de ES1 sería de 8K.
- Decodificar los huecos o dar "CE(RAM2) con A12" como única señal: el sector 8000H– 9FFFH es exacto para el bloque; A12 solo separa sus dos filas internas.
- Olvidar WE̅ en RAM1, RAM2, ES1 y ES2 (la EPROM no lleva WE), o conectar direcciones internas de más: EPROM CI A11–A0, RAM2 CI A11–A0, RAM1 A9–A0, E/S A10–A0.
- "Centro del mapa" mal interpretado: 10000H/2 = 8000H (no 8000 posiciones).
- "Centro del mapa" mal interpretado: 10000H/2 = 8000H (no 8000 posiciones).
Esquema-resumen de la metodología
- Derivar el espacio de la CPU del problema anterior — A15–A0 y D7–D0 del P2 fijan 64K posiciones × 8 bits y el mapa 0000H–FFFFH; decláralo, el P3 no lo repite.
- Pasar tamaños a hex y calcular inicio/fin de cada bloque según su anclaje — al comienzo (base 0000H), "justo después" (fin previo + 1), "centro" (10000H/2 = 8000H), dirección dada (C000H) y "acaba al final" (inicio = FFFFH − tamaño + 1 = FC00H).
- Comprobar cabida y huecos — suma de tamaños (29K ≤ 64K) y comprobación tamaño = final − inicio + 1 en cada fila; los huecos resultantes (4800H–7FFFH, A000H–BFFFH, C800H–FBFFH) se listan pero no se decodifican.
- Montar cada bloque con los CIs permitidos — expansión de palabras × bits con CIs 4K×4: 2 CI en paralelo por fila (D3–D0 y D7–D4); EPROM 8 CI, RAM2 4 CI, RAM1 2 CI sobredimensionadas con A11,A10 fijas a 0 — justifícalo en una línea.
- Fijar cuántas líneas se decodifican — el bloque más pequeño (1K) consume A9–A0 → decodificar con las 6 líneas altas A15–A10; con menos habría solapes.
- Escribir la ecuación CS de cada bloque con su polaridad — CE ALTO: producto directo de las líneas altas; CE BAJO: producto negado (NAND/burbuja); respeta WE̅ solo donde el enunciado lo da.
- Elegir y justificar la estructura de decodificación — 3–8 habilitado en A15,A14,A13 + puertas por CS, o ecuaciones puras con A15–A10 (las dos son válidas; el examen solo pide "un decodificador y las puertas").
- Dibujar el diagrama lógico completo — CPU, buses con nº de líneas, decodificador con sus entradas y salidas Yk, puertas por CS, filas de CI en paralelo y WE̅ a RAM1, RAM2, ES1 y ES2.
- Pasar la decodificación a VHDL — una expresión concurrente por señal sobre A15–A10, salidas vectoriales por filas; analizar con GHDL.
- Barrer todas las direcciones del mapa — cada dirección en 0 o 1 bloque y conteos = tamaños (16.384/2.048/8.192/2.048/1.024, resto hueco): es lo que caza polaridades invertidas y fronteras mal calculadas (FC00H vs F400H).
Idea transversal: el mapa lo fijan solo los anclajes del enunciado; el decodificador es la parte de decisión propia, y tanto uno como otro se validan barriendo las 65.536 direcciones, no probando direcciones sueltas.
Checklist final antes de entregar
- [ ] P1: cálculo 6 s = 150.000.000 pulsos = MOD-10⁶ (20 bits) × MOD-150 (8 bits); ASM de 8 estados nombrados (PARADA, ESPERA_6S, MUEVE_IZQ/DER, GIZ_ALEJA/ACERCA, GDER_ALEJA/ACERCA); pulsadores leídos solo en PARADA; vuelta completa en ALEJA + ACERCA; F/H nivel con salida a PARADA al cesar; G sin espera de 6 s; VHDL con proceso secuencial + combinacional + contador habilitado solo en ESPERA_6S y nombres = estados ASM; señal de giro de rueda nombrada y declarada.
- [ ] P2: fetch T0–T3 común y marcado como "carga y decodificación"; direcciones de 16 bits con dos lecturas y RT de puente (byte alto primero); MUL3 = dos sumas vía RT (nunca una); contaje de PC 1+2+3 con el 3º incremento en la lectura del byte bajo; SUBR: SUB←PC después del PC+1 final; JUMP Z decide sin tocar la ALU (condición Z, MPC←A+Z); STAC: MDR←AC (C10C9=10) + pulso WE̅; STOP: bucle sin señales; UC: MPC 6 bits + MC 64×24 + CMBR + MUX 5:1 (000 MPC+1, 001 A+Z, 010 A, 011 vector IR, 100 000000); vector 08H→04H … 0FH→39H; tabla de microinstrucciones.
- [ ] P3: mapa 0000H–FFFFH (16 líneas); tabla EPROM 0000H–3FFFH · ES1 4000H–47FFH · RAM2 8000H–9FFFH · ES2 C000H–C7FFH · RAM1 FC00H–FFFFH; huecos 4800H–7FFFH, A000H–BFFFH, C800H–FBFFH; 8+4+2 CIs (expansión palabras × bits); decodificador 3–8 en A15–A13 + puertas, o ecuaciones con A15–A10; CE̅ = OR negada y CE = producto; WE̅ a RAM1, RAM2, ES1, ES2; módulo VHDL equivalentes.