Guía de resolución — Examen de Sistemas Digitales II, Julio 2023 (07-07-2023)
Guía modelo para preparar la convocatoria de nov-dic 2026. El examen tiene 3 problemas: procesador multiplicador por sumas sucesivas — UO + microprograma + unidad de control microprogramada (3 p), el mismo sistema con diagrama ASM + VHDL (3 p) y CPU con UO unida a un espacio de 256 posiciones + mapa de memoria EPROM/E-S/RAM (4 p).
Importante (del propio enunciado): el planteamiento de cada ejercicio es clave y no se puntúan los ejercicios cuyo planteamiento no sea adecuado. Escribe siempre 2-3 frases de planteamiento antes de desarrollar, justifica cada elección y deja el resultado final verificable (tablas, código, valores concretos).
Verificación de esta guía: ejecutada con GHDL 4.1.0 y Python 3. (1) El microprograma
RT del P1 se ejecutó sobre un modelo Python de la UO: 5×4=20 en 34 microciclos (fórmula
general 6+7·AR µc), 7×0=0 en 6 µc (con la guarda del multiplicador 0), 15×15=225 en 111 µc,
0×7=0, 8×9=72, 13×11=143, 4×4=16, 1×1=1, 15×1=15 — todo correcto.
(2) El VHDL del multiplicador ASM del P2 está reescrito al estilo de los apuntes
(proceso único con wait until clk='1' + reset síncrono + STD_LOGIC_UNSIGNED) y se
compila y simula con GHDL 4.1.0 --std=08 -fsynopsys: el bloque de la guía, analizado
literal y byte a byte, pasa un testbench que coteja flanco a flanco BR/AR/PR/DONE contra
la fórmula del ASM (9 casos: 5×4=20; límite 15×15=225; guarda 7×0=0 con 0 vueltas y
0×7=0; 1×1=1; 13×11=143; 1×15=15; 15×1=15; 8×9=72 — AR vueltas exactas en cada uno),
con reset a mitad de bucle y DONE de un solo reloj; las mutaciones del banco anterior
quedan pendientes de re-ejecutar (ver notas de elaboración). (3) El microprograma
simbólico del P3 se ejecutó sobre un modelo Python del datapath de la figura (palabra de
8 bits) con un programa test (LDA/INC/MUL2/SUB/STOP): 43 microciclos; M[0EH]: 6→7→14,
SUB→M[0CH]=14−4=10, PC=0BH al STOP; en un segundo test, MUL2 de 9→18 (exacto en 8 bits),
MUL2 de 128→0 con flag C y SUB 2−4=254 (complemento a 2, con préstamo). La ROM simbólica
usa 31 microinstrucciones → MPC de 6 bits. (4) El decodificador del mapa se barrió en GHDL
(--std=08) y en un barrido Python independiente en las 256 direcciones: CE correctas en
las 256, 0 solapes y recuento exacto EPROM=32, E/S=16, RAM2=16, RAM1A=64, RAM1B=64,
hueco=64 (16+48). El barrido detectó además un error real de ecuación (confundir A6 en
40H): comprueba siempre las direcciones frontera.
Supuestos declarados (escríbelos en el examen)
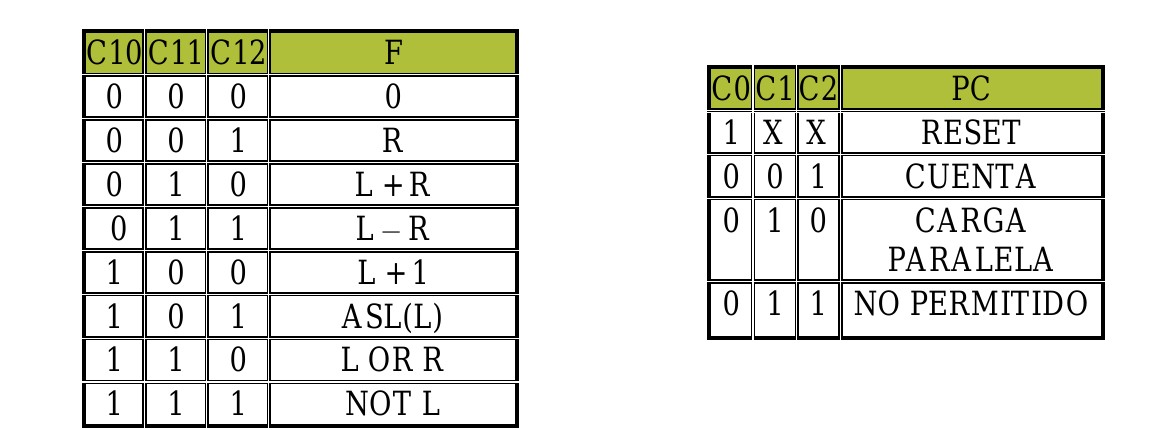
- Tabla ALU (se lee completa y en orden en el examen): filas tal como vienen impresas,
encabezado
C10 C11 C12de izquierda a derecha como bit más significativo:
| C10 C11 C12 | F |
|---|---|
| 0 0 0 | 0 (salida de la ALU a 0) — permite PR ← 0 |
| 0 0 1 | R (paso del operando derecho) |
| 0 1 0 | L + R |
| 0 1 1 | L − R |
| 1 0 0 | L + 1 |
| 1 0 1 | ASL(L) (shift left lógico) |
| 1 1 0 | L OR R |
| 1 1 1 | NOT L |
La solución es la misma bajo cualquier permutación de C10-C11-C12: solo cambian los cables
del decodificador de la ALU. Decláralo y listo.
2. P1: la UO la diseño yo (lo pide el enunciado): bus interno compartido de 8 bits,
registros con conductor tri-state al bus (EN_x) y carga paralela desde el bus (LD_x),
más un conductor de constante 1 para poder hacer AR ← AR − 1 con L − R.
3. P3: la palabra de datos es de 8 bits según la figura del examen — un diagrama
que el texto del PDF no contenía (es una imagen incrustada, recuperada en
figuras/jul23/recortes/figura-2-unidad-operativa-incrustada.png): la memoria aparece
rotulada «ESPACIO DIRECCIONABLE 256×8» y todos los buses llevan barra «8». El opcode de
8 bits (00000001…) cabe entero en la palabra de M[PC] y cada <dir> ocupa una posición
completa: 00H–FFH, sin límite de página cero. Longitudes (se deducen de los operandos
<dir>, el enunciado no las da): LDA/INC/MUL2 = 2 posiciones (opcode + dir), SUB = 4
(opcode + 3 dirs), STOP = 1. Registros dibujados en la figura (todos de 8 bits): PC con
la tabla C0–C2, MUX(C3) que carga MAR(C4), memoria con EN(C6) y R/W(C5), BUFFER(C7)→R de
la ALU, IR(C8), A(C9)→L, ALU(C10–C12) y flags C/Z(C13); no hay MDR bidireccional, ni
latches A/B, ni DIR1/DIR2. Lectura de memoria: EN activo durante el microciclo y captura
en el registro al flanco; escritura: el dato va al bus y R/W pasa a escritura.
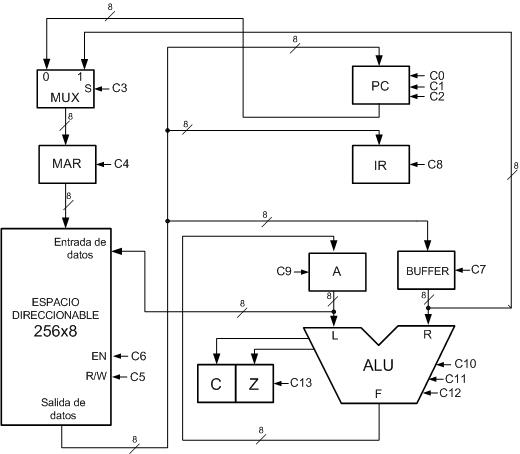
4. Tabla de control del PC (al final del texto, desordenada): C0 C1 C2 = 1xx RESET
(PC←0), 001 CUENTA (PC+1), 010 CARGA PARALELA, 011 NO PERMITIDO. Supuesto:
000 = mantenimiento (el PC no cambia) — es el único código que queda y lo usa STOP.
Problema 1 — Procesador multiplicador por sumas sucesivas (3,0 puntos)
Planteamiento (cópialo o parafréalo — es lo que te juegas el ejercicio). Se diseña un
procesador de propósito específico que multiplica dos números binarios sin signo de 4 bits
mediante sumas sucesivas: el producto es PR = BR + BR + … (AR sumandos). La UO contiene los
registros BR(4), AR(4) y PR, una ALU con las funciones de la tabla (L+R para acumular, L−R
para decrementar AR como contador, 0 para poner PR a 0, R para test de AR=0) y un flag Z.
El control es microprogramado: un microprograma en notación de transferencia de registros
gobernado por una unidad de control de tipo multiplexor–contador–memoria. El producto máximo
es 15·15 = 225, luego PR debe ser de 8 bits (regla práctica: los anchos se suman, 4+4=8; y
en efecto 225 < 256 = 2⁸, bastan 8; con 4 bits habría desborde).
Baremo: UO: 1,5 p · microprograma RT: 0,75 p · UC microprogramada: 0,75 p.
1.1 Cálculos previos (van en el papel, puntúan)
- 15 × 15 = 225 y el acumulando PR suma hasta 15 sumandos de ≤15: PR ∈ [0, 225] ⊂ [0,255] → PR de 8 bits. Máximo 15 sumas → AR sirve de contador en el propio bucle (no hace falta contador aparte): ahorro de hardware.
- Microciclos del microprograma (bucle de 7 µc + guarda de 3 + cargas 2 + DONE 1): 6 + 7·AR µc si AR > 0; 6 µc si AR = 0 — medidos por simulación: 5×4 en 34 µc, 1×1 en 13, 13×11 en 83, 15×15 en 111.
- Memoria de control: 13 microórdenes (T0..T12) → 16 posiciones (4 bits de MPC) × ~20 bits de campo (desglose exacto en 1.4).
- El ALU debe sumar productos parciales de 8 bits → L, R y C de 8 bits; bus interno de 8 bits; BR y AR se conectan al bus con los 4 bits altos forzados a 0 (extensión a cero) y al cargar desde el bus solo toman los 4 bits bajos.
1.2 Unidad operativa (1,5 p)
Señales exteriores: clk, START, entradas de datos B_ENT(4), A_ENT(4) (multiplicando
y multiplicador), salida DONE, salida de producto PR.
Diagrama de bloques (dibújalo así en el examen):
                 ┌──────┐  EN_BR   ┌──────────── bus interno de 8 bits ───────────┐
   B_ENT(4) ───→ │ BR   │─────────→│                                             │
   (carga paralela  │ 4b │          │      ┌───┐        ┌───┐                    │
    directa desde   └────┘          ├─────→│ L │───┐    │ R │───┐                │
    los pines, LD_BR*)              │      │ 8b│   │  ┌→│ 8b│   │   ┌─────┐ EN_C│
                 ┌──────┐  EN_AR   │      └───┘   └─→│ └───┘   └──→│ ALU │────→│
   A_ENT(4) ───→ │ AR   │─────────→│      LD_L↑   C10-C12  LD_R↑   │ 8b  │     │
                 │  4b  │←──LD_AR──│                       Z ←─────│decod│     │
   (LD_AR*)      └──────┘          │                       (C=0)   └─────┘     │
                 ┌──────┐  EN_PR   │       ┌───┐                               │
                 │ PR   │─────────→│(ext.0)│ 1 │──EN_1─────────────────────────┘
                 │  8b  │←──LD_PR──┤       └───┘   (conductor constante 1)
                 └──────┘────────→ D3..D0 (salida del sistema)
- Cada registro tiene dos señales: conductor tri-state al bus (EN_x; alta impedancia si no) y carga paralela desde el bus (LD_x, activa en el flanco).
- La ALU implementa las 8 funciones de la tabla (codificadas con C12C11C10 según el supuesto declarado) y genera Z = 1 cuando C = 0, capturado al cargar AR (y en el test inicial).
- BR y AR cargan además directamente desde los pines de entrada (LD_BR, LD_AR): es la vía de "recibir desde el exterior" del enunciado y evita un bus de entrada aparte.
- Justificación de anchos: bus 8 bits porque PR y C son de 8 bits; L/R 8 bits porque suman
parciales de 8; AR − 1 se hace con L − R requiriendo el operando constante 1 (de ahí el
conductor
1).
1.3 Microprograma en transferencia de registros (0,75 p)
T0 :  BR ← B_ENT ; AR ← A_ENT              (cargas paralelas desde los pines)
T1 :  PR ← 0                               (ALU = 0 [cod 000] ; LD_PR)
     —— guarda del multiplicador 0 (¡evita que 7×0 entre en bucle!) ——
T2 :  bus ← AR ; R ← bus                   (EN_AR ; LD_R)
T3 :  ALU ← R [cod 001] ; Z ← (C = 0)
T4 :  si Z = 1 → T12 (DONE)  [JZ]
     —— cuerpo del bucle: una suma ——
T5 :  bus ← PR ; L ← bus                   (EN_PR ; LD_L)
T6 :  bus ← BR ; R ← bus ; ALU ← L + R [cod 010]
T7 :  bus ← C ; PR ← bus                   (EN_C ; LD_PR)      PR := PR + BR
     —— decremento de AR (contador) y fin de iteración ——
T8 :  bus ← AR ; L ← bus                   (EN_AR ; LD_L)
T9 :  bus ← 1  ; R ← bus ; ALU ← L − R [cod 011]
T10:  bus ← C ; AR ← bus (4 bits bajos) ; Z ← (C = 0)          AR := AR − 1
T11:  si Z = 0 → T5 (vuelve al cuerpo del bucle)  [JNZ; con Z = 1 cae en T12]
T12:  DONE ← 1 ; esperar nuevo START                          (halt)
Traza del ejemplo del enunciado (5 × 4), obtenida ejecutando el microprograma sobre un modelo de la UO:
| tras… | PR | AR | Z |
|---|---|---|---|
| T1 | 0 | 4 | 0 |
| T7 (1ª suma) | 5 | 4 | 0 |
| T10 (1ª vuelta) | 5 | 3 | 0 |
| T7 (2ª) | 10 | 3 | 0 |
| T10 (2ª) | 10 | 2 | 0 |
| T7 (3ª) | 15 | 2 | 0 |
| T10 (3ª) | 15 | 1 | 0 |
| T7 (4ª) | 20 | 1 | 0 |
| T10 (4ª) | 20 | 0 | 1 |
Con Z = 1 en T10, el JNZ de T11 no salta y MPC pasa a T12.
PR = 20 tras 34 microciclos (T0..T11 con 4 vueltas + guarda + DONE). Medidos también por simulación: 7×0 = 0 en 6 µc (la guarda T2-T4 sale directa a DONE), 15×15 = 225 en 111, 13×11 = 143 en 83, 4×4 = 16 en 34, 0×7 = 0, 8×9 = 72, 1×1 = 1 y 15×1 = 15 (13 µc).
📚 Teoría: Tema 5, pág. 7–8 del PDF «Tema 5 SD-II_20230215.pdf» — procesador de propósito específico: algoritmo y microprograma simbólico de transferencia de registros.
Nota de diseño que luce: la guarda del multiplicador 0 usa la función R (cod 001) de la
tabla para testear AR sin alterarlo; sin guarda, la primera vuelta ya suma BR y AR ← AR − 1
con AR=0 envuelve a 15: el bucle llega a 16 vueltas y PR = 16·BR — con 7×0 daría 112 en vez
de 0, un resultado incorrecto, no solo un bucle lento (comprobado por simulación: 115 µc).
1.4 Unidad de control microprogramada (0,75 p)
Arquitectura multiplexor – contador – memoria (la clásica de la asignatura):
 START ─┐                                                            señales de la UO:
 Z ─────┼→┌────────────┐  dirección  ┌────────────┐                C10-C12, EN_*, LD_*,
 T4,T11─┼→│ MULTIPLEXOR │───────────→│ CONTADOR   │──MPC(4b)──→ ┌──────────────────┐
        │ │ próximo MPC │←───────────│    MPC     │             │ MICRO-ROM 16 × ~20│
        │ └────────────┘   MPC+1     │   4 bits   │             │ (T0..T12)         │
        └────────────────────────────└────────────┘             └──────────────────┘
- Micro-ROM: 16 palabras (hacen falta 13: T0..T12 → MPC de 4 bits) × ~20 bits de campo: ALU(3) + EN(5: BR, AR, PR, 1, C) + LD(5: L, R, PR, AR, +cargas de pines T0) + captura Z(1)
- campo de salto: dirección destino(4) + control de salto(2: no saltar / saltar si Z / saltar si ¬Z) ≈ 20 bits.
- Contador MPC: incrementa con MPC+1 salvo microinstrucciones condicionales: T4 salta a T12 si Z=1; T11 salta a T5 si Z=0 (codificado: el destino va en la propia microorden y el multiplexor selecciona MPC+1 frente al destino según Z).
- Multiplexor de arranque: con START=1 se fuerza MPC←T0 (puede implementarse con la entrada RESET/sincronismo del contador).
- DONE se genera por descodificación de la dirección T12 (o bit dedicado en la palabra).
📚 Teoría: Tema 5, pág. 4–5 del PDF «Tema 5 SD-II_20230215.pdf» — estructura de la UC microprogramada: CMBR, campos de la microorden, saltos por MPC y condiciones. 📚 Teoría: Tema 5, pág. 9–10 del PDF «Tema 5 SD-II_20230215.pdf» — dimensionado de la memoria de control: posiciones ≥ microprograma y campos de la palabra binaria.
Errores típicos P1
- PR de 4 bits → 15×15=225 desborda (el caso límite del examen).
- No prever cómo obtener el "1" para AR − 1: o se declara el conductor de constante, o se usa otra ruta; no dejarlo resuelto deja el microprograma imposible.
- Olvidar la guarda AR=0: con multiplicador 0 (p. ej. 7×0) el bucle da 16 vueltas y PR=16·BR=112 — resultado incorrecto, no un caso neutro (0×N sí funcionaría sin guarda).
- Bus de 4 bits con PR de 8 (incoherencia de anchos): justifica el bus de 8.
- Poner el flag Z "mirando AR" sin decir de dónde sale (debe venir de la salida C de la ALU).
Problema 2 — El mismo sistema solo con ASM + VHDL (3,0 puntos)
Planteamiento. El mismo multiplicador se controla ahora con una máquina de estados clásica (sin microprograma): estados nombrados INICIO → CARGA → BUCLE → FIN; en BUCLE se ejecuta una suma (PR ← PR + BR) y un decremento del multiplicador (AR ← AR − 1) por flanco, con test Z al terminar cada resta; el producto se recoge en PR y DONE marca el fin. El VHDL refleja literalmente los bloques del ASM (mismos nombres de estados y transferencias): es la "otra cultura" de control del mismo datapath del problema 1.
Baremo: diagrama ASM: 1,5 p · código VHDL del ASM: 1,5 p.
2.1 Diagrama ASM (1,5 p)
 ┌───────────┐  START=0
 │  INICIO   │←──────────┐   START=1
 └───────────┘           │
      │ (test START)     │
      └──────────────────┴──→ ┌────────────────────────────┐
                              │ CARGA                      │
                              │ BR ← B_ENT ; AR ← A_ENT    │
                              │ PR ← 0                     │
                              └────────────┬───────────────┘
                                     ( AR = 0 ? )  ── 1 ──┐   ← guarda multiplicador 0
                                     │ 0                  │
                                     ▼                    │
                  ┌────────→ ┌──────────────────────────┐ │
                  │          │ BUCLE                    │ │
                  │          │ PR ← PR + BR             │ │
                  │          │ AR ← AR − 1              │ │
                  │          └────────────┬─────────────┘ │
                  │                  ( AR − 1 = 0 ? )     │   ← esto es el flag Z
                  │                   │ 0      │ 1        │
                  └───────────────────┘        ▼          ▼
                                       ┌─────────────────────┐
                                       │ FIN                 │
                                       │ DONE ← 1            │
                                       └──────────┬──────────┘
                                                  └→ INICIO
Claves del ASM que puntúan: caja de estado + test en cada decisión; el bucle hace la transferencia dentro del estado (una suma por flanco de reloj); el test de fin se hace después del decremento (Z = "AR−1 = 0"); la cuenta exacta es AR iteraciones (5×4: cuatro vueltas, PR = 5,10,15,20). Numera los bloques (1 INICIO, 2 CARGA, 3 BUCLE, 4 FIN).
📚 Teoría: Tema 3, pág. 15–19 del PDF «Tema 3 SD-II_20200413.pdf» — cajas de estado, decisión y condición; bloque ASM = un ciclo de reloj. 📚 Teoría: Tema 3, pág. 23–24 del PDF «Tema 3 SD-II_20200413.pdf» — diagrama ASM y módulo VHDL equivalente (ejemplo resuelto).
2.2 VHDL del diagrama ASM (1,5 puntos)
library IEEE;
use IEEE.STD_LOGIC_1164.ALL;
use IEEE.STD_LOGIC_UNSIGNED.ALL;    -- aritmética de vectores, como en los apuntes

entity multiplicador is
  port ( clk   : in  std_logic;
         reset : in  std_logic;                        -- reset síncrono (Tema 3, pág. 30–32)
         START : in  std_logic;
         B_ENT : in  std_logic_vector(3 downto 0);   -- multiplicando -> BR
         A_ENT : in  std_logic_vector(3 downto 0);   -- multiplicador -> AR
         DONE  : out std_logic;
         BR, AR : out std_logic_vector(3 downto 0);
         PR    : out std_logic_vector(7 downto 0) ); -- 8 bits: 15x15=225
end entity;

architecture asm of multiplicador is
  -- nombres de estado = las 4 cajas del ASM (1 INICIO, 2 CARGA, 3 BUCLE, 4 FIN)
  type mis_estados is (INICIO, CARGA, BUCLE, FIN);
  signal estado : mis_estados;
begin
  ------- proceso secuencial UNICO = ASM completo -------
  process
  begin
    wait until clk = '1';
    if reset = '1' then
      estado <= INICIO;   DONE <= '0';
      BR <= "0000";  AR <= "0000";  PR <= (others => '0');
    else
      case estado is
        when INICIO =>
          DONE <= '0';
          if START = '1' then estado <= CARGA; end if;      -- test START
        when CARGA =>
          DONE <= '0';
          BR <= B_ENT;  AR <= A_ENT;                        -- cajas BR, AR
          PR <= (others => '0');                            -- caja PR ← 0
          if A_ENT = "0000" then estado <= FIN;             -- guarda multiplicador 0
          else estado <= BUCLE; end if;
        when BUCLE =>
          PR <= PR + ("0000" & BR);                       -- PR ← PR + BR (BR rellena a 8)
          AR <= AR - 1;                                     -- AR ← AR − 1
          DONE <= '0';
          if AR - 1 = "0000" then estado <= FIN; end if;    -- test "AR−1 = 0" = Z
        when FIN =>
          DONE <= '1'; estado <= INICIO;
        when others =>
          estado <= INICIO; DONE <= '0';
      end case;
    end if;
  end process;
end architecture;
Notas para el examen: con STD_LOGIC_UNSIGNED no falta ninguna conversión — los
vectores se suman, restan y comparan directamente, y ("0000" & BR) es la extensión a
cero del sumando al ancho de PR (igual que en la UO del P1; en VHDL moderno se escribe
resize, que no es el estilo de los apuntes). Ojo con los paréntesis de la
concatenación: + liga más que &, así que sin ellos PR + "0000" & BR sumaría
PR + "0000" y concatenaría BR al resultado (vector de 12 bits → desborda PR). El test
AR − 1 = "0000" reproduce literal el rombo del ASM (también vale AR = "0001" antes
del decremento: es lo mismo).
El reset síncrono es obligatorio en la traducción Tema 3 aunque el enunciado no lo
nombre: durante reset=1 la máquina está en INICIO con BR=AR=PR=0 y DONE=0. PR, BR
y AR se escriben justo donde el ASM hace la transferencia (son registros del ASM, como
los contadores); DONE, que es salida de estado (vale 1 solo en FIN), se escribe en
todas las ramas.
Verificación real con GHDL 4.1.0 (--std=08 -fsynopsys, bloque de la guía analizado
literal, TB nueva sobre la estructura nueva): el testbench observa solo puertos y
coteja flanco a flanco la evolución de BR, AR y PR contra la fórmula del ASM
(PR = k·B y AR = A−k tras k vueltas), comprueba la guarda de multiplicador 0, que DONE
dura un solo reloj (monitor paralelo) y el contaje INICIO+CARGA+BUCLE+FIN; los 9
casos del banco anterior pasan — 5×4=20, 15×15=225, 7×0=0 (0 vueltas), 0×7=0 (7
vueltas, PR=0), 1×1=1, 13×11=143, 1×15=15, 15×1=15, 8×9=72 — más un escenario de
reset a mitad de BUCLE (suelta la máquina a INICIO con todo a cero) y la invariante
DONE≤1 reloj en todo el paseo: TEST PASSED. Las tres mutaciones de ingeniería
inversa del testbench anterior (sin guarda → 7×0 da PR=112; PR de 4 bits → desborde
silencioso; salida off-by-one) no se han re-ejecutado contra esta estructura —
queda registrado en las notas de elaboración.
Los relojes por caso (banco anterior, misma estructura temporal: 1 INICIO con START + 1 CARGA + AR en BUCLE + 1 FIN + 1 reposo con DONE ya en 0, o sea AR + 4; en 7×0: 4 — la guarda salta el bucle entero, como la guarda T2–T4 del P1). El ASM no promete número de relojes: promete AR iteraciones, y eso es justo lo que comprueba el cotejo flanco a flanco.
📚 Teoría: Tema 3, pág. 30–32 del PDF «Tema 3 SD-II_20200413.pdf» — traducción de ASM a VHDL: descripción por estados con reloj y reset.
Errores típicos P2
- PR de 4 bits (desborde en 15×15=225).
- Nombres de estados VHDL que no coinciden con los del ASM del apartado a (es lo que se puntúa como coherencia).
- Test de Z antes de la suma → bucle una iteración corto o largo (off-by-one).
- Sin test AR=0 en CARGA → con multiplicador 0 el bucle entra igual: AR − 1 envuelve a 1111 y da 16 sumas (medido mutando este bloque: 7×0 acaba con PR = 16·BR = 112, como el contra-test del P1 sin guarda T2-T4 — resultado incorrecto, no caso neutro).
- Asignaciones bloqueantes (
:=) dentro del proceso secuencial para los registros: mezclar estilos; usar señales no bloqueantes + variable solo para el test de AR−1.
Problema 3 — CPU microprogramada + mapa de memoria (4,0 puntos)
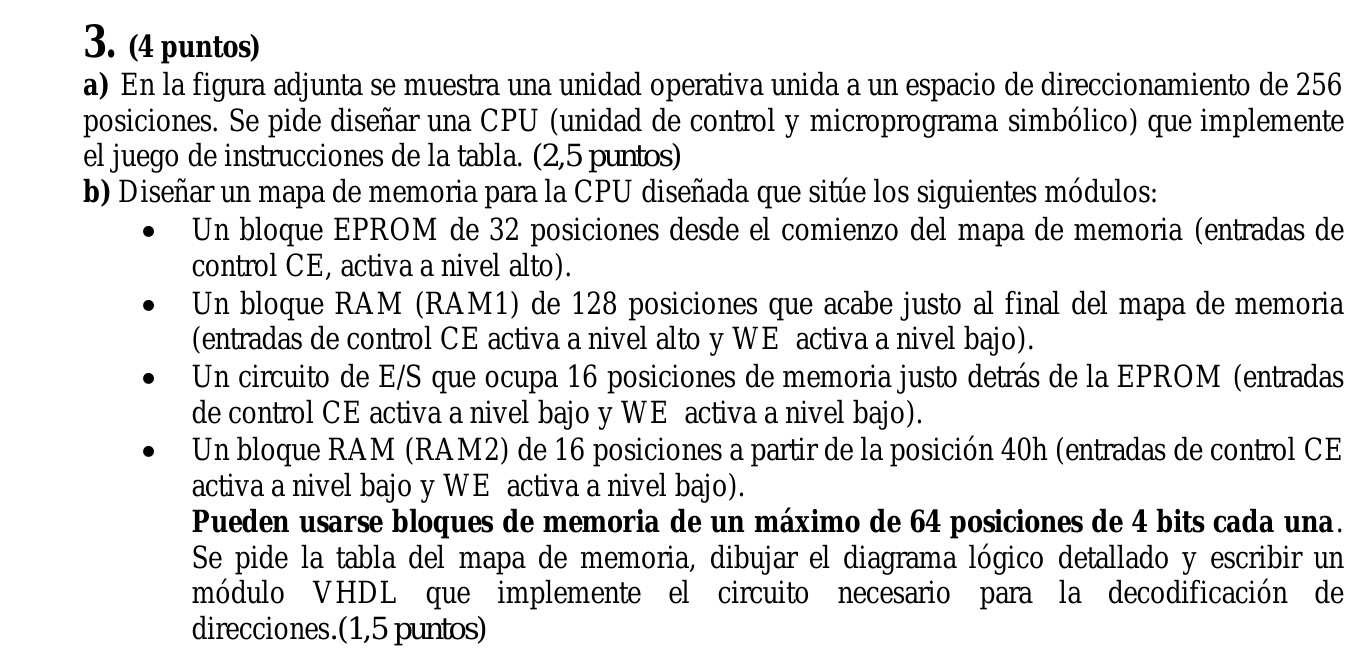
Planteamiento. La figura adjunta del examen (pág. 2) muestra una unidad operativa de bus único de 8 bits unida a un espacio de 256 posiciones (la memoria está rotulada «ESPACIO DIRECCIONABLE 256×8»): es una CPU von Neumann de palabra 8 bits con la UO en el propio espacio de memoria — la microinstrucción es el byte en M[PC]. Con los recursos y las señales de control C0–C13 que dibuja la figura (PC, MUX→MAR, memoria con EN y R/W, BUFFER, IR, A, ALU y flags C/Z), se diseña en a) la unidad de control microprogramada (multiplexor–contador–memoria, con el multiplexor de próximo microciclo gobernado por el opcode en IR tras el fetch) y el microprograma simbólico de las 5 instrucciones. En b), se reparte el mapa 00H–FFH en EPROM, E/S y dos RAM con CIs de máximo 64×4 —lo que obliga a 2 CIs en paralelo por posición de 8 bits—, respetando activos mixtos de CE (alta en EPROM y RAM1; baja en E/S y RAM2) y WE̅, dejando huecos y generando la decodificación en VHDL.
Baremo: a) UC + microprograma simbólico: 2,5 p · b) mapa + diagrama + decodificador VHDL: 1,5 p.
Datos que fija la figura y decisiones de diseño. Fija la figura: bus único de 8 bits
y memoria «256×8» → palabra de 8 bits, dirección de 8 líneas A7–A0; el opcode de 8 bits del
examen cabe ENTERO en la palabra de M[PC] (desaparece el antiguo problema de "valen los 4
bajos": era un error de lectura de la figura en la versión previa de esta guía); los recursos
y sus señales: PC(C0–C2), MUX 2:1 con S=C3 y entrada 0←PC que carga MAR(C4), memoria con
EN(C6) y R/W(C5) y datos unidos al bus, BUFFER(C7)→R de la ALU, IR(C8), A(C9)→L, ALU con
C10–C12 y salida F al bus, flags C/Z con carga C13; la tabla ALU (L+1=100, ASL(L)=101,
L−R=011) y la tabla PC (1XX=RESET, 001=CUENTA, 010=CARGA PARALELA, 011=NO PERMITIDO). Fija el
enunciado de 3.b los tamaños y anclajes de los bloques, sus polaridades CE/WE y el máximo de
CIs de 64×4. No lo fijan: el código 000 de la tabla PC —en la tabla impresa del examen
no hay fila 000—, que se declara inferido como mantenimiento (lo usa STOP); las
longitudes de instrucción (LDA/INC/MUL2 = 2 posiciones: opcode + <dir>; SUB = 4; STOP = 1 —
se deducen de los operandos <dir>, y con palabra de 8 bits cada <dir> ocupa una posición
entera y abarca 00H–FFH); la entrada 1 del MUX (la trazada de la figura es ambigua: BUFFER o
bus) — la guía asume MUX(1) ← BUFFER, que basta para las 5 instrucciones y permite que
SUB no necesite registros extra; y el dispatch desde IR (la figura no le dibuja salida: el
envío al multiplexor de direcciones es decisión del alumno). Con 8 bits, A guarda M[d1] de SUB
mientras se lee d2: no hacen falta los DIR1/DIR2 que la versión previa de esta guía
añadía por trabajar con palabra de 4 bits.
3.a ISA y microprograma (2,5 p)
ISA literal de la tabla del examen (los códigos de 8 bits se guardan enteros en la palabra de M[PC]; longitudes inferidas de los operandos, el enunciado no las da):
| Instrucción | Cod. (byte) | Longitud | Semántica | Microciclos (fetch+ejec) |
|---|---|---|---|---|
LDA <dir> |
00000001 | 2 | A ← M[dir] | 3+4 = 7 |
INC <dir> |
00000010 | 2 | M[dir] ← M[dir]+1 | 3+5 = 8 |
MUL2 <dir> |
00000011 | 2 | M[dir] ← ASL(M[dir]) = 2·M[dir] | 3+5 = 8 |
| SUB d1 d2 d3 | 00000100 | 4 | M[d3] ← M[d1] − M[d2] | 3+13 = 16 |
| STOP | 00000101 | 1 | PC en mantenimiento, CPU parada | 3+1 = 4 |
📚 Teoría: Tema 5, pág. 14–15 del PDF «Tema 5 SD-II_20230215.pdf» — ISA de ejemplo y códigos de operación (LDA <dir>: A ← M(<dir>)).
Recursos REALES de la figura (todos de 8 bits) con sus señales de control, tal como los dibuja el examen: PC con la tabla C0C1C2 (1XX=RESET PC←0, 001=CUENTA, 010=CARGA PARALELA del bus, 011=NO PERMITIDO; 000 = mantenimiento, inferido — la tabla del examen no trae fila 000); MUX 2:1 con selección C3, entrada 0 ← PC y entrada 1 ← BUFFER (supuesto de trazado), que carga MAR con C4; memoria «256×8» con entrada/salida de datos unidas al bus general, EN ← C6 y R/W ← C5; BUFFER con carga C7 — es el registro de datos: alimenta la entrada R de la ALU y además vierte al bus (unión dibujada); IR con carga C8 (guarda el opcode para el dispatch); A con carga C9 — alimenta L de la ALU y vierte al bus; ALU con selección C10–C12 y salida F al bus; flags C/Z con carga C13 (esta ISA no los consulta nunca: decláralo). Lectura de memoria: con EN activo y R/W en lectura durante el microciclo, el dato está válido en el bus y el registro que se carga en el flanco lo captura (la convención «BUFFER ← M[MAR]» de la teoría); escritura: el dato ya está en el bus (sale de A) y R/W se pone en escritura. La figura no dibuja ningún MDR bidireccional separado: BUFFER hace ese papel, y no hay latches A/B ni temporales DIR1/DIR2.
📚 Teoría: Tema 5, pág. 22 del PDF «Tema 5 SD-II_20230215.pdf» — procesador completo de referencia con RAM 256×8 y registros BUFFER/A.
Microprograma simbólico (las 3 primeras posiciones son el fetch común; la última microinstrucción de cada bloque salta a 00H; el dispatch se hace en la posición 02H con un multiplexor de direcciones gobernado por el opcode en IR; direcciones de microprograma en hex):
FETCH común (00H–02H):
00H: MAR ← PC                        (bus ← PC; MUX S=C3→0; carga C4)
01H: IR ← M[MAR] ; PC cuenta (001)   (EN=C6 activo, R/W=C5 lectura; carga IR C8)
02H: próximo ← IR (dispatch)         (multiplexor; bus libre, memoria sin EN)
     00000001→03H  00000010→07H  00000011→0CH  00000100→11H  00000101→1EH

LDA (03H–06H):
03H: MAR ← PC
04H: BUFFER ← M[MAR] ; PC cuenta     (el operando <dir>)
05H: MAR ← BUFFER                    (MUX S=C3→1; carga C4)
06H: A ← M[MAR] ; → 00H              (bus ← M[MAR], el registro A C9 lo captura)

INC (07H–0BH):
07H: MAR ← PC ; 08H: BUFFER ← M[MAR], PC cuenta ; 09H: MAR ← BUFFER   (<dir>)
0AH: A ← M[MAR]                                               (valor v en L)
0BH: M[MAR] ← L+1 (C10C11C12=100) ; C13 ; → 00H   (F al bus; R/W escritura: guarda v+1)

MUL2 (0CH–10H): igual que INC pero con 10H: M[MAR] ← ASL(L) (101) ; C13 ; → 00H
   [con palabra de 8 bits ASL es ×2 exacto: MUL2 de 9 deja 18; solo desborda
    si M[dir] ≥ 80H, p. ej. 128 → 0 y flag C=1]

SUB d1 d2 d3 (11H–1DH):
11H: MAR ← PC ; 12H: BUFFER ← M[MAR], PC cuenta ; 13H: MAR ← BUFFER ; 14H: A ← M[MAR]  (A= M[d1])
15H: MAR ← PC ; 16H: BUFFER ← M[MAR], PC cuenta ; 17H: MAR ← BUFFER ; 18H: BUFFER ← M[MAR] (R = M[d2])
19H: A ← F(L−R) (011) ; C13          (L=A conserva M[d1] desde 14H; el resultado queda en A)
1AH: MAR ← PC ; 1BH: BUFFER ← M[MAR], PC cuenta ; 1CH: MAR ← BUFFER   (d3)
1DH: bus ← A ; M[MAR] ← bus (R/W escritura) ; → 00H

STOP (1EH): PC en mantenimiento (C0C1C2 = 000) ; MPC ← 1EH (bucle auto-puntado; bus libre)
Microinstrucciones: fetch 3 + LDA 4 + INC 5 + MUL2 5 + SUB 13 + STOP 1 = 31 (posiciones 00H–1EH) → MPC de 6 bits (64 palabras ≥ 31). Formato orientativo (~30 bits): próximo-MPC(6) + selección de condición/dispatch(2–3) + las 14 líneas de control del examen C0–C13. UC: multiplexor–contador–memoria como en el modelo de la teoría, con la entrada IR gobernando el multiplexor en la posición 02H.
📚 Teoría: Tema 5, pág. 17–18 del PDF «Tema 5 SD-II_20230215.pdf» — microprograma simbólico: fetch común (MAR ← PC; IR ← M(MAR), PC ← PC+1) y dispatch por código de operación. 📚 Teoría: Tema 5, pág. 4–6 del PDF «Tema 5 SD-II_20230215.pdf» — estructura de la UC: MPC, memoria de control, registro CMBR, campo de selección de condiciones. 📚 Teoría: Tema 5, pág. 9 del PDF «Tema 5 SD-II_20230215.pdf» — dimensionado: nº de posiciones y campos según microprograma, señales y condiciones.
Verificación (modelo Python ejecutado del datapath de la figura, palabra 8 bits):
programa test en 00H: LDA 0EH · INC 0EH · MUL2 0EH · SUB 0EH 0FH 0CH · STOP, con
M[0EH]=6, M[0FH]=4. Resultado medido en 43 microciclos: A=6 tras LDA; M[0EH] = 7 tras
INC y 14 tras MUL2; SUB → M[0CH] = 14 − 4 = 10; M[0FH] intacto; PC = 0BH al
llegar a STOP. Segundo test de desbordes en 8 bits: MUL2(9) = 18 (exacto: en la versión
errónea de 4 bits de esta guía daba 2 por perder el acarreo) y MUL2(128) = 0 con flag
C=1; SUB(2−4) = 254 (complemento a 2) con C=1 por préstamo. Observación de
diseño (declárala): SUB reutiliza A como temporal de M[d1] y del resultado, y destruye el
acumulador previo; con otra temporal se preservaría (y harían falta registros extra que la
figura no dibuja).
Errores típicos P3.a
- Confundir el ancho de palabra: la figura rotula la memoria «256×8» y todos sus buses llevan
barra «8» → el opcode de 8 bits cabe entero en M[PC] y no hay «truco de los 4 bits
bajos». Consecuencia: cada
<dir>ocupa una posición entera y vale 00H–FFH (sin límite de página cero). - Olvidar que INC/MUL2 escriben en memoria (microciclo con R/W en escritura) y que el dato escrito viaja por el bus (salida F de la ALU).
- SUB: no prever dónde guardar M[d1] mientras se lee d2 (el sitio natural es A — decláralo y advierte que lo destruye; si añades DIR1/DIR2, di explícitamente que son extensión, la figura no los dibuja).
- Usar C0C1C2=011 (NO PERMITIDO) o asumir la fila 000 sin declararla: la tabla impresa del examen solo trae 1XX/001/010/011; el mantenimiento es inferencia.
- Olvidar PC cuenta tras cada posición de operando consumida (PC quedaría mal alineado).
- Señales de la figura sin usar: la lectura necesita EN (C6) activo, no solo R/W; la carga de flags C13 existe aunque esta ISA nunca consulte los flags; el dispatch debe declararse (IR no tiene salida dibujada).
- Intercambiar los operandos de la ALU: L siempre viene de A y R de BUFFER — en SUB, invertir L y R deja el resultado complementado (M[d2] − M[d1]).
3.b Mapa de memoria, diagrama y decodificador (1,5 p)
Tabla del mapa (palabra de 8 bits; CIs de máximo 64 posiciones × 4 bits → cada posición de 8 exige 2 CIs en paralelo, una con D3–D0 y su gemela con D7–D4; el entrelazado de bits NO cambia la decodificación de direcciones):
| Direcciones | Módulo | Nº pos. | CI(s) ≤64×4 | CE | WE | Líneas de dirección del CI |
|---|---|---|---|---|---|---|
| 00H – 1FH | EPROM | 32 | 2 de 32×4 en paralelo (4+4 bits) | CE (alto) | — (ROM) | A4…A0 |
| 20H – 2FH | E/S | 16 | módulo de 8 bits (hecho con CIs de 4: 2 de 16×4 en paralelo) | CE̅ (bajo) | WE̅ (bajo) | A3…A0 |
| 30H – 3FH | hueco | 16 | — | — | — | — |
| 40H – 4FH | RAM2 | 16 | 2 de 16×4 en paralelo | CE̅ (bajo) | WE̅ (bajo) | A3…A0 |
| 50H – 7FH | hueco | 48 | — | — | — | — |
| 80H – BFH | RAM1-A | 64 | 2 de 64×4 en paralelo (D3–D0 y D7–D4) | CE (alto) | WE̅ (bajo) | A5…A0 |
| C0H – FFH | RAM1-B | 64 | 2 de 64×4 en paralelo | CE (alto) | WE̅ (bajo) | A5…A0 |
Total: 8 CIs de memoria ≤64×4 (EPROM 2 + RAM2 2 + RAM1 4, en dos filas de 2 en paralelo) más el módulo E/S. Comprobaciones (dibújalas): RAM1 de 128 "acaba justo al final" → 255−128+1 = 128 = 80H; E/S "justo detrás de la EPROM" → 20H-2FH; huecos 30H-3FH (16) y 50H-7FH (48); usados 32+16+16+128 = 192, huecos 64; 192+64 = 256 ✓. Direccionamiento interno: cada CI usa las líneas bajas que necesita (32→A4-A0, 16→A3-A0, 64→A5-A0); el resto van al decodificador. Las dos CIs en paralelo de un bloque comparten direcciones y CE: una aporta los 4 bits bajos del bus D3–D0 y la otra los altos D7–D4 (expansión de bits).
📚 Teoría: Tema 5, pág. 32 del PDF «Tema 5 SD-II_20230215.pdf» — mapa de memoria y capacidad direccionable según el bus. 📚 Teoría: Tema 5, pág. 40 del PDF «Tema 5 SD-II_20230215.pdf» — habilitaciones CE/EN de cada integrado en un sistema de 8 líneas de dirección.
Ecuaciones del decodificador (con A7 como bit más significativo; ¡40H = 0100 0000 tiene A6=1, error típico que mi primer borrador cometió y el barrido de simulación pilló):
CS_EPROM = A7̧·A6̧·A5̧                    → CE_EPROM (activa ALTO, directo)
CS_IO    = A7̧·A6̧·A5·A4̧                 → CE̅_IO   = ¬CS_IO   (activa BAJO, invertido)
CS_RAM2  = A7̧·A6·A5̧·A4̧                 → CE̅_RAM2 = ¬CS_RAM2 (activa BAJO, invertido)
CS_RAM1A = A7·A6̧                        → CE_RAM1A (ALTO, directo)
CS_RAM1B = A7·A6                         → CE_RAM1B (ALTO, directo)
📚 Teoría: Tema 5, pág. 34–35 del PDF «Tema 5 SD-II_20230215.pdf» — condiciones de habilitación según las líneas altas de dirección; puertas lógicas o PLA.
Diagrama lógico (descríbelo/dibújalo): entrada A7-A0 → red de AND con inversores según las ecuaciones anteriores; las salidas de los bloques con CE activa ALTO (EPROM, RAM1A, RAM1B) van directas; las de CE activa BAJO (E/S, RAM2) pasan por un inversor. WE̅ viene de la CPU y se conecta solo a E/S, RAM2, RAM1A y RAM1B (nunca a la EPROM). Bus de datos D7–D0 común a todos los módulos: cada bloque lo atiende con dos CIs en paralelo (pares EPROM-1/EPROM-2, RAM2-1/RAM2-2, RAM1-A1/RAM1-A2 y RAM1-B1/RAM1-B2), cada una con sus 4 líneas de datos (D3–D0 una, D7–D4 la otra) y las mismas direcciones y CE que su gemela; direcciones: EPROM ← A4-A0, E/S y RAM2 ← A3-A0, RAM1 ← A5-A0. El SVG de abajo dibuja los rangos y las CIs dobladas en paralelo por bloque; la red de puertas del decodificador aplica exactamente las ecuaciones de arriba.
Módulo VHDL del decodificador (simulado en GHDL, barrido completo): es decodificación
directa por compuertas con las polaridades del enunciado — ya es el estilo de clase, no
hay nada que modernizar ni que cambiar (el std_logic de los apuntes); único ajuste del
pase de estilo: reverificar el barrido contra este bloque (12/11, GHDL --std=08
-fsynopsys): mismos números que el banco original.
library IEEE;
use IEEE.STD_LOGIC_1164.ALL;

entity dec_mapa is
  port ( A        : in  std_logic_vector(7 downto 0);
         CE_EPROM : out std_logic;   -- activa ALTO
         CE_IO_N  : out std_logic;   -- activa BAJO
         CE_RAM2_N: out std_logic;   -- activa BAJO
         CE_RAM1A : out std_logic;   -- activa ALTO
         CE_RAM1B : out std_logic ); -- activa ALTO
end entity;

architecture behavior of dec_mapa is
  signal sel_ep, sel_io, sel_r2 : std_logic;
begin
  sel_ep <= not A(7) and not A(6) and not A(5);
  sel_io <= not A(7) and not A(6) and     A(5) and not A(4);
  sel_r2 <= not A(7) and     A(6) and not A(5) and not A(4);   -- 40H = 0100 0000

  CE_EPROM  <= sel_ep;
  CE_IO_N   <= not sel_io;
  CE_RAM2_N <= not sel_r2;
  CE_RAM1A  <= A(7) and not A(6);
  CE_RAM1B  <= A(7) and     A(6);
end architecture;
Resultado del barrido completo (testbench GHDL --std=08 sobre las 256 direcciones +
barrido Python independiente de las ecuaciones, ambos coinciden; aserción en cada
dirección de "0 o 1 bloque activo" y recuento final):
Posiciones habilitadas: EPROM=32  E/S=16  RAM2=16  RAM1A=64  RAM1B=64  hueco=64 (16+48)
Solapes: 0   Total: 32+16+16+64+64+64 = 256 ✓
RAM1 completa (RAM1A+RAM1B) = 128 ✓ → 4 CIs de 64×4 al doblar los bits (D3–D0/D7–D4)
DECODIFICADOR OK EN LAS 256 DIRECCIONES
📚 Teoría: Tema 5, pág. 36–37 del PDF «Tema 5 SD-II_20230215.pdf» — descripción VHDL de la decodificación del mapa (dos versiones). 📚 Teoría: Tema 1, pág. 33–34 del PDF «Tema 1 SD-II_20200206.pdf» — descripción VHDL de un decodificador, con línea de enable.
Truco de examen para repasar tus ecuaciones sin simulador: comprueba las cuatro direcciones frontera de cada bloque — 00H/1FH (EPROM), 20H/2FH (E/S), 30H/3FH (ninguno), 40H/4FH (RAM2), 50H/7FH (ninguno), 80H/BFH y C0H/FFH (RAM1) — escribiendo A7A6A5A4 en binario de cada una; si en 40H te sale A6=0, la ecuación está mal.
Errores típicos P3.b
- CE mixtas: poner todas las CE activas igual, o no invertir CS para E/S/RAM2 (o al revés: invertir también EPROM/RAM1). Es justo lo que el examen quiere comprobar.
- Conectar WE̅ a la EPROM.
- RAM1 colocada "desde 80H" sin comprobar que acaba en FFH: coincide, pero hay que justificarlo (128 + X − 1 = FFH → X = 80H).
- Expansión de bits olvidada: con bus de datos de 8 (la figura) y CIs de 4 bits, cada posición lleva 2 CIs en paralelo siempre: RAM1 son 4 CIs de 64×4 (2 filas en cascada por A6 × 2 gemelas), no 2; EPROM 2 y RAM2 2. La versión previa de esta guía contaba 1+1+2 porque asumía palabra de 4 bits contra la figura.
- Olvidar los huecos 30H-3FH y 50H-7FH (el hueco grande está entre RAM2 y RAM1: 50H-7FH, 48 posiciones, no 32).
- Ecuación de RAM2 con A6 negada (40H=0100 0000 → A6=1). Verificado en simulación.
Esquema-resumen de la metodología
- Leer la figura antes que nada — el rótulo «256×8» y las barras «8» de los buses fijan la palabra de 8 bits, los nombres reales (BUFFER, A, MUX→MAR) y las 14 señales C0–C13; cualquier supuesto de 4 bits contradice la figura y cambia el microprograma y el recuento de CIs del mapa.
- Separar lo que fija la figura/enunciado de lo que se infiere — declarados: 000 = «mantenimiento» (la tabla PC del examen no trae fila 000), longitudes 2/2/2/4/1 (de los operandos
<dir>), MUX(1)←BUFFER (trazado ambiguo), dispatch desde IR (sin salida dibujada). - Fetch común con las señales reales — MAR ← PC (C3=0, C4); lectura con EN (C6) y R/W (C5) capturada en IR (C8) al flanco; PC cuenta (001); dispatch por opcode en la posición 02H del multiplexor.
- Un microciclo por lectura+captura — con EN activo el dato está en el bus durante el microciclo y el registro cargado en el flanco lo guarda (convención «BUFFER ← M[MAR]» de la teoría).
- Enrutar cada instrucción por L=A y R=BUFFER — INC/MUL2: valor en A, L+1/ASL(L) y escritura (R/W); SUB: M[d1] en A mientras se lee d2 a BUFFER, L−R de vuelta a A, y escritura de d3 desde A (sin DIR1/DIR2: decláralo).
- Dimensionar la UC — 31 microinstrucciones → MPC de 6 bits; palabra de microorden ≈ 30 bits: próximo-MPC + selección de condición + las 14 líneas del examen.
- Validar el microprograma con un modelo Python — programa test LDA/INC/MUL2/SUB/STOP: 43 microciclos, M[0EH] 6→7→14, M[0CH]=10, PC=0BH; desbordes en 8 bits (MUL2 128→0 con C=1; SUB 2−4=254 con C=1).
- Colocar los bloques del mapa y calcular inicio/fin — comienzo (00H), "justo detrás" (20H), dirección dada (40H), "acaba al final" (80H = FFH−128+1); huecos 30H-3FH y 50H-7FH no se decodifican; 192 usados + 64 hueco = 256.
- Montar cada bloque con expansión de bits — CIs ≤64×4 y bus de 8 → 2 CIs en paralelo por fila (D3–D0 y D7–D4): EPROM 2, RAM2 2, RAM1 4 (dos filas separadas por A6); en paralelo comparten direcciones, CE y WE̅.
- Escribir las ecuaciones CS con su polaridad, pasarlas a VHDL y barrer las 256 direcciones — CE alta = producto directo, CE baja = producto invertido; conteos exactos EPROM 32 / E/S 16 / RAM2 16 / RAM1 64+64 / hueco 64 y 0 solapes en GHDL y Python: es lo que caza la frontera 40H (A6=1) y las polaridades invertidas.
Idea transversal: el ancho de palabra de la figura (8 bits) arrastra todo — opcode entero, <dir> de un byte, y 2 CIs por posición en el mapa; tanto el microprograma como el decodificador se validan ejecutándolos (modelo Python y barrido de las 256 direcciones), no con ejemplos sueltos.
Resumen de baremo y tiempos recomendados (120 min)
| Problema | Baremo | Recomendación |
|---|---|---|
| 1. Multiplicador UO+µprog+UC | 3,0 (1,5/0,75/0,75) | ~35 min; el ancho de PR y la guarda AR=0 dan puntos de justificación |
| 2. ASM + VHDL | 3,0 (1,5/1,5) | ~30 min; estados VHDL = nombres del ASM |
| 3. CPU + mapa | 4,0 (2,5/1,5) | ~55 min; no descuides b): 1,5 p muy agradecidas con las fronteras comprobadas |